Repetitorium
- 1 Grundlegendes zur Abschlussarbeit/Projektarbeit/Seminararbeit/Essay
- 2 Gliederung der Arbeit
- 3 Daten aus unterschiedlichen Formaten in R einlesen.
- 4 Daten für die Analyse aufbereiten (Variablen recodieren, Umgang mit Missing Values, Variabeln klassifizieren, Umbenennen von Variablennamen).
- 4.1 Verwendete Daten / Beschreibung
- 4.2 Daten anschauen (inspizieren)
- 4.3 Daten recodieren
- 4.4 -9 durch NA ersetzen
- 4.5 Fälle die weniger als 80% im Fragebogen ausgefüllt haben löschen
- 4.6 Klassifizierung von Variablen
- 4.7 Umbenennen von Variablennamen
- 4.8 Weitere nützliche Befehle
- 4.9 Der „Pipe Operator“ %>%
- 4.10 Fehlende Werte: Möglichkeiten und Grenzen
- 4.11 Alle quantitativen Variablen auf numerisch klassifizieren
- 5 Datenstruktur prüfen (Korrelation, Dimensionsreduktion, Dimensionen zusammenfassen).
- 6 Dimensionsreduktion (Ausführlicher bei Dimensionsreduktion)
- 7 Voraussetzung für eine barrierefreie Datenanalyse.
- 8 Daten skalieren.
- 9 Grundlagen der Inferenzstatistik (Kurze Wiederholung aus dem Studium: Was ist wirklich relevant, um die Inferenz zu verstehen!
- 9.1 Test auf Normalverteilung
- 9.2 Korrelationstest
- 9.3 Lineare multiple Regressionsanalyse
- 9.4 t-Tests
- 9.5 Einfaktorielle Varianzanalyse (ANOVA)
- 9.6 Multivariate Varianzanalyse (MANOVA)
- 9.7 Post-hoc Test bei der Varianzanalyse
- 9.8 Chi-Quadrat-Unabhängigkeitstest
- 9.9 Auf was ist zu achten bei der Fragebogenerstellung (Art der Fragen, Skalierung, etc.)?
- 10 Versuchsplanung
- 11 Mögliche Darstellung von Tabellen
- 12 Wie kann ich vermeiden zu häufig gleiche Wörter zu verwenden?
© Prof. Dr. Oliver A. Gansser | oliver@gansser.de | www.gansser.de
1 Grundlegendes zur Abschlussarbeit/Projektarbeit/Seminararbeit/Essay
Folgende Unterlagen sind als Dateien zur Verfügung zu stellen:
- Arbeit als PDF (Achtung: Fragebogen kommt immer in den Anhang der Arbeit, niemals die Auswertungen, diese kommen in die Arbeit, siehe hierzu mein Leitfaden)
Alles, was wichtig ist kommt in die Arbeit und alle was nicht wichtig ist kommt nicht in die Arbeit und dann auch nicht in Anhang (Regel!).
Codebook: Hier ist die Kodierung der Fragen im Fragebogen enthalten (Genauer: Welche Variable in den Daten entspricht welcher Frage im Fragebogen, in Soscisurvey heiß dieses Codebook die Variablenliste und ist abrufbar)
Rohdatendaten als csv so codiert, dass die Daten mit dem Codebook übereinstimmen. Rohdaten sind Daten die weder bearbeitet noch bereinigt sind.
Flüchtigen Quellen (Internetseiten), als pdf.
R-Skript oder das RMarkdown der Datenanalyse.
2 Gliederung der Arbeit
Wissenschaftliche Arbeiten sind immer gleich/ähnlich gegliedert:
- Einleitung
- Theorie und Forschungsstand
- Methodik
- Ergebnisse
- Fazit/Diskussion
=> Leitfaden
3 Daten aus unterschiedlichen Formaten in R einlesen.
Wichtig: Datenfenster (rechts oben in RStudio) sollte vor dem Start der Datenanalyse immer leer sein.
Wo liegen die Daten?
=> Irgendwo in einem Ordner, oder irgendwo im WWW.
=> Einfachste Möglichkeit: Einen relativen Pfad verwenden, d.h. man gibt nur den Dateinamen mit Endung an und muss aber das Skript im gleichen Ordner haben wie die Daten.
Bsp: absoluter Pfad:
read.csv2("C:/Users/MaxMustermann/Dokumente/Daten.csv")Bsp: relativer Pfad:
read.csv2("Daten.csv")Relativer Pfad funktioniert nur, wenn die Daten im aktuellen Arbeitsverzeichnis (WD) liegen. Kontrolle mit getwd()
Nicht zu empfehlen ist der Import über die Menüleiste in Environment, da dann mit der Maus umständlich gesucht werden muss und diese Suche nicht Skript dokumentiert werden kann.
3.1 Arbeitsverzeichnis von R Studio
getwd() #Suchen des aktuelle Arbeitsverzeichnises
setwd('C://datei/pfad') #Wechselt das aktuelle Arbeitsverzeichnis.
Arbeitsverzeichnisse lassen sich aber viel einfacher wechseln, in dem R-Skripte in einem Ordner auf dem Rechner öffnet und somit das WD in diesen Ordner gesetzt wird. Das geht nur, wenn R-Studio noch nicht geöffnet ist.
Deshalb => Zum Start der Datenanalyse nicht RStudio, sondern das Skript mit RStudio öffnen.
Zur Kontrolle vom Workspace: getwd()
Wichtig noch vor dem Start: Einstellung RStudio: Tools/Global Options/Code: Hier bei Savings Default Text encoding auf UTF-8 einstellen.
Die Daten, die wir hier verwenden heißen “Daten_GFK.csv”
Achtung
Sind die Daten auch csv? Überprüfen mit: anschauen mit Text-Editor. CSV in Deutschland ist immer ; separiert
Zur Not (wenn nicht richtig abgespeichert) mit Excel öffnen und als CSV (Trennzeichen getrennt) speichern und nochmals kontrollieren mit Text-Editor.
Achtung Feldtrennzeichen: ; = deutsch (in R => csv2) und , = Rest der Welt (in R => csv)
Beim Einlesen in R lautet die Einlesefunktion für einen csv Datei:
bei ; getrennten Variablen => read.csv2()
bei , getrennten Variablen => read.csv()
3.2 Daten einlesen
Die Daten zum Repetitorium können Sie unter http://www.gansser.de/data/Daten_GFK.csv kostenlos downloaden.
- Möglichkeit: Zuerst Daten speichern, dann Daten einlesen
Wenn Sie die Daten in einen Ordner legen und dann ein Skript in R Studio anlegen, können Sie die Daten ganz einfach mit den folgenden Befehlen einlesen. Wenn Sie später mit einem R-Skript die Daten einlesen möchten, genügt das Öffnen des Skriptes und ausführen der Befehle. Dieses Vorgehen macht den Umgang mit Daten sehr einfach. Aus dem csv.2 Datenformat, wenn die Datei bereits auf dem Rechner gespeichert ist:
data<-read.csv2("Daten_GFK.csv")- Möglichkeit: Zuerst Daten einlesen, dann speichern (s.u.)
data<-read.csv2("http://www.gansser.de/data/Daten_GFK.csv")Wenn Daten aus dem Internet geladen werden, sind die Daten nicht auf dem Rechner, bevor sie nicht gespeichert werden. Insbesondere bei Apple Rechnern ist dies die bevorzugte Variable, da Apple u. u. die Daten anders abspeichern.
Tipp: Wenn Sie Ihre Arbeit unterbrechen, dann hinterlassen Sie Ihr Skript so (Speichern nicht vergessen), das sie beim Öffnen des Skriptes das Skript einfach durchlaufen lassen könne (Alles Markieren mit Str+Alt und dann Ausführen mit run) und dann an der Stelle weiterarbeiten an der Sie zuletzt gearbeitet haben. Damit werden alle Prozesse vom Einlesen bis zur Aufbereitung und Datenanalyse nochmals durchgeführt. Das hat den Vorteil, dass Sie immer nur mit einem Datensatz und mit einem funktionierenden Skript arbeiten, dass Sie dann bei der Abgabe der Arbeit zusammen mit den Daten auch fehlerfrei abgeben können. Was bei Ihnen läuft, läuft auch auf jedem anderen Rechner. Zudem kann auf diese Weise auch das Zusammenarbeiten in Projektgruppen erleichtert werden z. B. über ein gemeinsames Laufwerk (wo auch immer das liegt).
Für Projektgruppen bietet sich auch die RStudio Cloud an. Achtung: Jede Person hat nur 15 Freistunden und 15 Projekte in der Cloud.
Aus .Rdata Datenformat erfolgt das Einlesen über load und mit anderer Endung:
save(data, file="Daten_GFK.Rdata")
rm(data) #löscht den bestehenden Datensatz in der Environment
load("Daten_GFK.Rdata")# Beim Laden von Rdata Daten immer ohne Zuweisung
Anmerkung: Ohne eine Zuweisung mit data<- werden die Daten nur eingelesen, aber nicht in die Arbeitsumgebung (Environment) von R geladen.
<- ist ein Zuweisungsbefehl, der das was rechts davon steht, dem Objekt links davon zuweist. In unserem Fall die eingelesenen Daten dem data.frame data. Somit zeugt und RStudio in der Environment rechts den Datensatz data an.
3.3 Daten speichern
Als csv Daten:
write.csv2(data, file = "filename.csv") # Achtung auch hier wieder auf deutsches Format achtenAls RData:
save(data, file = "filename.Rdata")In der Regel erfordert das Arbeit mit Rohdaten und einem R-Skript kein Speichern von bearbeiten Daten, da die Bearbeitung über das Skript läuft. D. h. alle Änderungen erfolgen mit Ausführung des Skriptes, es lässt sich somit ein Datensalat (Im Sinne von veränderten Daten oder Daten die jeden Tag neu abgespeichert werden müssen) vermeiden.
4 Daten für die Analyse aufbereiten (Variablen recodieren, Umgang mit Missing Values, Variabeln klassifizieren, Umbenennen von Variablennamen).
# Laden von Mosaic (ggf. vorher installieren mit install.packages())
library(mosaic)
4.1 Verwendete Daten / Beschreibung
In der nachfolgenden Analyse wird ein Datensatz verwenden bei dem die Berufliche Belastung und die Gesundheit als multiattributives Konstrukt gemessen wurde. Zusätzlich wurde die Berufliche Belastung als Auswahlentscheidung (ja/nein) gemessen. Außerdem wurde das Geschlecht und der akademische Abschluss erfasst. Nachfolgend ist die Codierung der Konstrukte (oder in diesem Fall sogar das Codebook) aufgelistet:
| Berufliche Belastung (Maslach MBI) | Items |
|---|---|
| V3_1 | Ich fühle mich von meiner Arbeit emotional ausgelaugt. |
| V3_2 | Ich fühle mich am Ende eines Arbeitstages geschafft. |
| V3_3 | Ich fühle mich erschöpft, wenn ich morgens aufstehe und wieder einen Arbeitstag vor mir habe. |
| V3_4 | Immer mit Menschen zu arbeiten, bedeutet eine große Anspannung für mich. |
| V3_5 | Ich fühle mich ausgebrannt von meiner Arbeit. |
| V3_6 | Ich fühle mich frustriert in meinem Beruf. |
| V3_7 | Ich fühle, dass ich in meinem Beruf zu hart arbeite. |
| V3_8 | Es bedeutet für mich zu viel Stress, direkt mit Menschen zu arbeiten. |
| V3_9 | Ich habe das Gefühl, als ob ich am Ende wäre. |
| Berufliche Belastung | Item |
|---|---|
| V8 | Wenn Sie eine Entscheidung treffen müssten, wie würden Sie antworten? (ja = 1, nein = 2) |
| Gesundheit | V9 = Gesundheit am AP, V10 = allgemeine Gesundheit |
|---|---|
| V9_1 | Waren Sie in den letzten 12 Monaten aufgrund ihrer Arbeitsbelastung oft krankgeschrieben? |
| V9_2 | Haben Sie den Wunsch nach einer Auszeit? |
| V9_3 | Hatten Sie schon einmal darüber nachgedacht, alles hinzuschmeißen? |
| V9_4 | Gibt es in Ihrem Unternehmen psychisch beanspruchte Mitarbeiter mit auffälligem Arbeitsverhalten? |
| V10_1 | Konzentrationsstörungen |
| V10_2 | Schlafstörungen |
| V10_3 | Antriebslosigkeit |
| V10_4 | Müdigkeitserscheinungen |
| V10_5 | Überlastungserscheinungen |
| V10_6 | Angespanntheitserscheinungen |
| Soziodemographische Daten | |
|---|---|
| V11_1 | Was für ein Geschlecht haben Sie? (männlich = 1, weiblich = 2) |
| V11_3 | Haben Sie einen akademischen Abschluss? |
4.2 Daten anschauen (inspizieren)
mosaic::inspect(data[1:21]) # das Paket mosaic wird oft von anderen Paketen überdeckt, deswegen sicherheitshalber mosaic nochmals speziell für diesen Befehl laden mit mosaic::##
## quantitative variables:
## name class min Q1 median Q3 max mean sd n missing
## 1 V3_1 integer 1 2.00 3.0 5.00 6 3.335821 1.440259 134 0
## 2 V3_2 integer 1 2.00 3.0 4.00 6 2.985075 1.359926 134 0
## 3 V3_3 integer -9 2.00 4.0 5.00 6 3.701493 1.923460 134 0
## 4 V3_4 integer -9 3.25 5.0 5.00 6 4.343284 1.856120 134 0
## 5 V3_5 integer -9 3.00 5.0 5.00 6 4.208955 1.911873 134 0
## 6 V3_6 integer -9 3.00 4.0 6.00 6 3.895522 2.528837 134 0
## 7 V3_7 integer -9 2.00 3.0 5.00 6 3.313433 2.132519 134 0
## 8 V3_8 integer -9 4.00 5.0 6.00 6 4.589552 2.177163 134 0
## 9 V3_9 integer 1 4.00 5.0 6.00 6 4.731343 1.532427 134 0
## 10 V8 integer -9 1.00 1.0 2.00 2 1.022388 1.824917 134 0
## 11 V9_1 integer 1 4.25 6.0 6.00 6 4.932836 1.467430 134 0
## 12 V9_2 integer 1 2.00 3.0 5.00 6 3.373134 1.817507 134 0
## 13 V9_3 integer 1 1.00 3.0 5.00 6 3.388060 1.969353 134 0
## 14 V9_4 integer 1 1.25 2.5 4.00 6 2.880597 1.617781 134 0
## 15 V10_1 integer 1 2.00 4.0 5.75 6 3.992537 1.692515 134 0
## 16 V10_2 integer 1 2.00 5.0 5.75 6 4.059701 1.711356 134 0
## 17 V10_3 integer 1 2.00 4.0 5.00 6 3.858209 1.730544 134 0
## 18 V10_4 integer -9 2.00 3.0 5.00 6 3.089552 1.997979 134 0
## 19 V10_5 integer 1 2.00 3.0 5.00 6 3.619403 1.684939 134 0
## 20 V10_6 integer 1 2.00 3.0 5.00 6 3.447761 1.706102 134 0
## 21 V11_1 integer -9 1.00 1.0 2.00 2 1.052239 2.045781 134 04.3 Daten recodieren
Eine Umpolung richtet sich nach der Itemformulierung und dem Codebook. Eine negative PCA-Ladung allein ist kein Grund zum Recodieren: Das Vorzeichen einer Komponente kann insgesamt umgekehrt werden, ohne die Lösung inhaltlich zu verändern.
Recodiert werden müssen Variablen dann, wenn Sie von ihrer inhaltlichen Aussage in eine Richtung gehen, aber in der Formulierung in eine andere Richtung gehen.
Z. B:
Frage 1: Ich finde BMW geil! (Skaliert von 1 = stimme überhaupt nicht zu bis 6 = stimme voll und ganz zu) Frage 2: Ich finde BMW bescheuert! (Skaliert von 1 = stimme überhaupt nicht zu bis 6 = stimme voll und ganz zu)
Wenn in diesem Fall die Einstellung zum BMW über den Mittelwert (mean) gemessen werden soll, würde dies zu einer Fehlinterpretation führen.
In diesem Fall muss eine der Variablen recodiert werden:
# 5 Personen werden befragt
Frage1<-c(6,5,6,6,5)
Frage2<-c(1,2,1,3,1)

Beispieldaten<-cbind(Frage1, Frage2)
Beispieldaten<-as.data.frame(Beispieldaten)

# Frage 2 soll recodiert werden
# Es wird immer vom Maximalwert +1 addiert (6+1=7).
# Und von dieser Zahl werden die zu recodierenden Daten subtrahiert
# 7-1=6, 7-2=5 ext.

Beispieldaten$Frage2<-7-Beispieldaten$Frage2
Beispieldaten
## Frage1 Frage2
## 1 6 6
## 2 5 5
## 3 6 6
## 4 6 4
## 5 5 64.4 -9 durch NA ersetzen
Bei vielen Online-Befragungsplattformen werden fehlende Werte (Missing Values) mit -9 abgespeichert. Das erkennen Sie mit inspect(), wenn beim min von favstats() die -9 steht. Würde man nun weiter die Daten analysieren, ohne die -9 richtig zu behandeln, würde -9 als Werte gerechnet werden und somit die Analyse verfälschen (Die Analyse wäre Makulatur).
Deshalb ersetzten wird -9 mit NA (not available) um dieses Feld als Missing Value zu kennzeichnen.
[] wird in R immer dann benötigt, wenn aus einem Datensatz (das Objekt vor der []) bestimmte Zellen angesprochen werden sollen. Anschließend wird mit <- die Zuweisung durchgeführt für diese Zellen.
NA ist in R immer ein leeres Feld.
data[data == -9] <- NA

inspect(data)
##
## categorical variables:
## name class levels n missing
## 1 V11_3 character 4 132 2
## distribution
## 1 Uni (37.9%) ...
##
## quantitative variables:
## name class min Q1 median Q3 max mean sd n missing
## 1 V3_1 integer 1 2.00 3.0 5.00 6 3.335821 1.4402591 134 0
## 2 V3_2 integer 1 2.00 3.0 4.00 6 2.985075 1.3599263 134 0
## 3 V3_3 integer 1 2.00 4.0 5.00 6 3.796992 1.5799856 133 1
## 4 V3_4 integer 1 4.00 5.0 5.00 6 4.443609 1.4533844 133 1
## 5 V3_5 integer 1 3.00 5.0 5.00 6 4.308271 1.5333685 133 1
## 6 V3_6 integer 1 3.00 5.0 6.00 6 4.190840 1.6177596 131 3
## 7 V3_7 integer 1 2.00 3.0 5.00 6 3.500000 1.5057143 132 2
## 8 V3_8 integer 1 4.00 5.0 6.00 6 4.795455 1.3964985 132 2
## 9 V3_9 integer 1 4.00 5.0 6.00 6 4.731343 1.5324273 134 0
## 10 V8 integer 1 1.00 1.0 2.00 2 1.330769 0.4723102 130 4
## 11 V9_1 integer 1 4.25 6.0 6.00 6 4.932836 1.4674297 134 0
## 12 V9_2 integer 1 2.00 3.0 5.00 6 3.373134 1.8175073 134 0
## 13 V9_3 integer 1 1.00 3.0 5.00 6 3.388060 1.9693533 134 0
## 14 V9_4 integer 1 1.25 2.5 4.00 6 2.880597 1.6177808 134 0
## 15 V10_1 integer 1 2.00 4.0 5.75 6 3.992537 1.6925146 134 0
## 16 V10_2 integer 1 2.00 5.0 5.75 6 4.059701 1.7113561 134 0
## 17 V10_3 integer 1 2.00 4.0 5.00 6 3.858209 1.7305438 134 0
## 18 V10_4 integer 1 2.00 3.0 5.00 6 3.180451 1.7048709 133 1
## 19 V10_5 integer 1 2.00 3.0 5.00 6 3.619403 1.6849389 134 0
## 20 V10_6 integer 1 2.00 3.0 5.00 6 3.447761 1.7061021 134 0
## 21 V11_1 integer 1 1.00 1.0 2.00 2 1.441860 0.4985444 129 54.5 Fälle die weniger als 80% im Fragebogen ausgefüllt haben löschen
# data<-data[-which(rowMeans(is.na(data)) > 0.2), ]
# Achtung: Funktioniert nur, wenn auch solche Fälle im Datensatz sind!!!

# Alternativ kann auch einen Variablenauswahl vorgenommen werden mit is.na(data[])
4.6 Klassifizierung von Variablen
4.6.1 Klassentypen
Bei manchen Analyseverfahren ist ein bestimmter Variablentyp notwendig. Eine Umklassifizierung erfolgt mitas.neueKlasse
data$Variable<- as.logical(data$Variable)
data$Variable<- as.numeric(data$Variable)
data$Variable<- as.character(data$Variable)
data$Variable<- as.factor(data$Variable)- B. Ist es sinnvoll, den Bildungsabschluss als Faktorvariable zu klassifizieren. Hier werden intern in R Zahlenwerte (levels) gespeichert, die auch eine bestimmte Reihenfolge haben.
levels(data$V11_3) # nicht sichbar## NULLstr(data$V11_3) # Es gibt 134 Wörter in der Variable## chr [1:134] "Uni" "Keinen akademischen Abschluss" "Fachhochschule" "Uni" ...data$V11_3<- as.factor(data$V11_3) # Umklassifizieren als Faktor
levels(data$V11_3) # Anzeige der levels nur mit Faktorvariable möglich## [1] "Fachhochschule" "Hochschule"
## [3] "Keinen akademischen Abschluss" "Uni"str(data$V11_3) # Levels sind dann nummeriert## Factor w/ 4 levels "Fachhochschule",..: 4 3 1 4 3 4 4 2 4 2 ...Falls Variablen nicht als Charakter eingelesen werden können, dann existiert das Problem, dass Variablen mit -9 für den Wert -9 einen Faktor bilden. Dieser kann eliminiert werden, in dem die Variable zuerst als Charakter klassifiziert wird, und dann erst -9 mit NA ersetzt wird. Anschließen kann diese Variable als Faktor klassifiziert werden.
4.6.2 Inhalt der Daten ändern/umbenennen
Wir sehen in der Rohdatenmatrix, dass V8 und V11_1 noch numerisch sind, aber eigentlich kategorial sein müssen.
inspect(data$V8)## # A tibble: 1 x 10
## class min Q1 median Q3 max mean sd n missing
## * <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <int> <int>
## 1 integer 1 1 1 2 2 1.33 0.472 130 4inspect(data$V11_1)## # A tibble: 1 x 10
## class min Q1 median Q3 max mean sd n missing
## * <chr> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <dbl> <int> <int>
## 1 integer 1 1 1 2 2 1.44 0.499 129 5# Diesen Zahlen muss ein Faktor zugewiesen werden
# numerisch in factor wandeln
data$V8<-as.factor(data$V8)
# Levels anzeigen
levels(data$V8)## [1] "1" "2"# Wörter zuweisen
levels(data$V8)<-c("ja", "nein")
levels(data$V8) # Im Datensatz wurde bei V8 1 mit ja und 2 mit nein ersetzt.## [1] "ja" "nein"Hier nochmal mit Geschlecht (V11_1)
data$V11_1<-as.factor(data$V11_1)
levels(data$V11_1)
## [1] "1" "2"levels(data$V11_1)<-c("männlich", "weiblich")
levels(data$V11_1)## [1] "m<U+00E4>nnlich" "weiblich"4.6.3 Levels tauschen
# setzt weiblich auf das erste level
data$V11_1 <- relevel(data$V11_1, "weiblich")
levels(data$V11_1)
## [1] "weiblich" "m<U+00E4>nnlich"Mehr dazu hier
4.6.4 Ersetzen von Inhalt B bei Variable XYZ mit Inhalt b
=> Vorher Variable duplizieren, da die Daten ja überschrieben werden.
data$XYZ<-data$ABC # aus Variable ABC wird Variabel XYZ
Das Ersetzen geht dann mit
data$XYZ[data$XYP == "B"] <- "b"
4.7 Umbenennen von Variablennamen
Es bietet sich an, bestimmt Variablen wie z. B. Geschlecht auch so zu benennen
Hilfreich ist an diese Stelle, wenn die Variablennummer der Variable bekannt ist. Einen Ausgabe der Variablennummerierung bekommt man mit t(colnames(data)). Wichtig: Variablennamen sollten nicht durch Leerzeichen getrennt sein. Stattdessen verwenden Sie ..
t(colnames(data))## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9] [,10]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9" "V8"
## [,11] [,12] [,13] [,14] [,15] [,16] [,17] [,18] [,19]
## [1,] "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3" "V10_4" "V10_5"
## [,20] [,21] [,22]
## [1,] "V10_6" "V11_1" "V11_3"names(data)[21] <- c("Geschlecht") # Name der Variable Nr. 21 wird mit "Geschlecht" überschrieben.
names(data)[22] <- c("Bildungsabschluss")
names(data)[10] <- c("Berufliche.Belastung")
t(colnames(data))## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss"Alternativ geht auch:
names(data)<-c("Geschlecht","Bildungsabschluss","Berufliche.Belastung","usw.") … in der Reihenfolge der Variablen.
4.8 Weitere nützliche Befehle
head(data) # gibt den Kopf (ersten 6 Zeilen) eines Datensatzes aus.
ls(data) # listet alle geladenen Objekte (hier die Variablen) auf
rm(data) #löscht geladene einzelne Objekte
data[1:10,c(10,21)] #zeigt die Zeile 1 bis 10 und Variable 10 und 21
data[1:10,] # zeigt die Zeile 1 bis 10 und alle Variablen
data[1,]    # zieht eine Zeile aus den Daten, hier die Zeile 1
data[,1]    # Zieht eine Spalte aus den Daten, hier die Spalte 1
data[1,10]   # Zieht den Wert von Zeile 1 und Spalte 10 aus den Daten
nrow(data)  # Anzahl Zeilen in der Matrix
ncol(data)  # Anzahl Spalten in der Matrix
dim(data)   # Anzahl Zeilen und Spalten in der Matrix

# Frage: Welche Zahle steht in Zeile 111 und Spalte 5?
data[111,5]

# Frage: Welche Zahlen stehen in Zeile 111 und 122 und Spalte 5?
data[c(111,122),5] # c = combine

# Frage: Welche Zahlen stehen in Zeile 111 und 122 und Spalte 10 und 21?
data[c(111,122),c(10,21)]

# Frage: Wie kann ich die letzte Matrix als eigenen Datensatz als `ds` speichern?
ds<-data[c(111,122),c(10,21)]
ds
4.9 Der „Pipe Operator“ %>%
Short-cut: Str/Shift/m
kann über das Paket library(dplyr) geladen werden, wird aber auch aus anderen Paketen, wie im nächsten Chunk, mit geladen. Wenn eine Fehlermeldung kommt, dann einfach dplyr nachladen.
Anmerkung: Das gilt im Übrigen für alle Fehlermeldungen. In der Regel lassen sich in R Fehler beheben, in dem man die Fehlermeldung durchliest und dann den Empfehlungen folgt. Notfalls den Fehler in eine Suchmaschine eingeben oder kopieren.
Eine passendere deutsche Übersetzung für diesen Operator ist „Rohr“ (engl. pipe) und funktioniert folgendermaßen:
- Nimm einen Datensatz (oder ein Daten-Objekt)
- Gib ihn mittels Rohrpost %>% an die nächste Zeile weiter
- Verkette so viele Funktionen, wie Du möchtest
Vorteil: Besser lesbarer Code und man kann geschachtelten Klammerausdrücke auflösen, und man muss Zwischenergebnisse nicht in Objekten speichern. Man kann auch schön Schritt für Schritt die ToDos bis zum %>% ausführen. Es lässt sich Schritt für Schritt nachverfolgen, was mit den Daten passiert.
Beispiel:
library(dplyr) # ggf vorher installieren mit install.packages ("dplyr")

mtcars%>%
  select(mpg,cyl) %>%
  filter(cyl>6) %>%
  filter(mpg<15)
## mpg cyl
## Duster 360 14.3 8
## Cadillac Fleetwood 10.4 8
## Lincoln Continental 10.4 8
## Chrysler Imperial 14.7 8
## Camaro Z28 13.3 8Probieren Sie selbst aus was passiert, wenn nur bis vor die ersten Pipe ausgeführt wird, dann die zweite, dritte und dann den ganzen Code.
Hinweise: Wenn im Code die Pipe genutzt wird und Sie den ganzen Code ausführen wollen, muss der Curser nur irgendwo im Code stehe. Sie müssen nicht dann ganzen Code markieren. Wenn jedoch markiert wird, wird auch nur der markierte Teil ausgeführt.
4.10 Fehlende Werte: Möglichkeiten und Grenzen
Vor der Auswertung werden Umfang, Muster und mögliche Ursachen fehlender Werte untersucht. Manche Funktionen bieten vollständige Fallauswahl oder paarweise Auswertung an. Welche Vorgehensweise angemessen ist, hängt von der Fragestellung und den Annahmen über die fehlenden Werte ab.
Das Ersetzen durch den Spaltenmittelwert erhält zwar den beobachteten Mittelwert, kann aber Varianzen und Zusammenhänge verzerren. Bei gewöhnlichen Tests wird die Unsicherheit der ersetzten Werte nicht angemessen berücksichtigt. Eine allgemeine Unbedenklichkeitsgrenze von beispielsweise 20 % gibt es nicht. Je nach Modell kommen unter anderem multiple Imputation oder Maximum-Likelihood-Verfahren infrage (Schafer und Graham, 2002).
Vorgehen in diesem Lehrbeispiel: Für die folgenden Auswertungen verwenden wir die vollständigen Fälle über die 22 eingelesenen Variablen. Die Zahl ausgeschlossener Fälle wird dokumentiert. Diese einfache Auswahl dient einem nachvollziehbaren gemeinsamen Analysedatensatz; sie ist keine allgemeine Empfehlung für jede Untersuchung. Bei systematisch fehlenden Angaben können auch durch Falllöschung Verzerrungen entstehen.
n_vor_auswahl <- nrow(data)
vollstaendig <- complete.cases(data)
table(vollstaendig)
## vollstaendig
## FALSE TRUE
## 22 112data <- data[vollstaendig, , drop = FALSE]
data.frame(vorher = n_vor_auswahl, nachher = nrow(data),
ausgeschlossen = n_vor_auswahl - nrow(data))## vorher nachher ausgeschlossen
## 1 134 112 22Eine reine Demonstration der Mittelwertimputation lässt sich an einer separaten Variable durchführen. Sie verändert den Analysedatensatz nicht:
beispiel <- c(2, 4, NA, 6)
beispiel_imputiert <- beispiel
beispiel_imputiert[is.na(beispiel_imputiert)] <- mean(beispiel, na.rm = TRUE)
beispiel_imputiert
## [1] 2 4 4 64.11 Alle quantitativen Variablen auf numerisch klassifizieren
Ganzzahlige Messwerte können für die weitere Verarbeitung in numerische Variablen umgewandelt werden. Das ändert ihre Werte nicht. Kategoriale Merkmale bleiben als Faktoren codiert. Eine technische Umwandlung macht ein ordinales Merkmal nicht automatisch metrisch. Hier verwenden wir mutate_if.
data<-data%>%
  mutate_if(is.integer, as.numeric)
5 Datenstruktur prüfen (Korrelation, Dimensionsreduktion, Dimensionen zusammenfassen).
Bevor Signifikanztest oder Zusammenhänge oder Abhängigkeiten bezüglich der aufgestellten Forschungshypothesen durchgeführt werden können, sollten die Daten hinsichtlich vorhandener Konstrukte überprüft werden. D. h. sind Konstrukte und deren Unterschiede/Zusammenhänge/Abhängigkeiten methodisch über die Datenerhebung erfasst worden, weil aus der Theorie zuvor so abgeleitet, dann müssen diese Konstrukte auch in den Daten wieder zu finden sein.
Beispiel: Sie wollen die unterschiedliche Reaktanz zwischen Männern und Frauen untersuchen, dann gibt es dazu Theorie, es wurde auch eine Hypothese abgeleitet und für die Datenerhebung wurden 5 Items zur Messung von Reaktanz und das Geschlecht erfasst (Operationalisierung). In Daten sind dann eine Variable für Geschlecht und 5 Variablen für die Reaktanz. Diese 5 Variablen sind nun bezüglich ihrer Struktur für das Konstrukt Reaktanz zu überprüfen und es ist eine neue Variabel zu bilden mit dem Namen Reaktanz.
5.1 Kontrolle der Variablennummern
Oftmals ist es nützlich zu wissen, welche Variable in welcher Spalte im Datensatz steht. Bsp. will man für eine Analyse die Variablen 1 bis 9 analysieren.
t(colnames(data))## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss"Variable 1 bis 9: Berufliche Belastung Variable 11 bis 20 Gesundheit
Es existiert keine Variable die Gesundheit oder Berufliche Belastung heißt, stattdessen gibt es viele Items dazu.
5.2 Korrelation
Zur ersten Inspektion der Zusammenhänge zwischen metrischen Items eignet sich eine Korrelationsmatrix. Diese ersetzt nicht die Prüfung des Messmodells. Die ausgewählten Fälle im Beispiel sind vollständig; bei anderen Daten muss der Umgang mit fehlenden Werten ausdrücklich festgelegt werden.
Der Befehl für die Korrelation lautet cor() und um die Auswahl einzelnen Variablen zu korrelieren verwendet man die []
cor(data[1:9])## V3_1 V3_2 V3_3 V3_4 V3_5 V3_6 V3_7
## V3_1 1.0000000 0.6834183 0.5657038 0.3401935 0.6097949 0.5071683 0.4973190
## V3_2 0.6834183 1.0000000 0.5966721 0.2821514 0.4593324 0.4713230 0.4410853
## V3_3 0.5657038 0.5966721 1.0000000 0.3110636 0.5516117 0.5930983 0.3091699
## V3_4 0.3401935 0.2821514 0.3110636 1.0000000 0.5629871 0.4668014 0.3754429
## V3_5 0.6097949 0.4593324 0.5516117 0.5629871 1.0000000 0.7528152 0.5443736
## V3_6 0.5071683 0.4713230 0.5930983 0.4668014 0.7528152 1.0000000 0.5095763
## V3_7 0.4973190 0.4410853 0.3091699 0.3754429 0.5443736 0.5095763 1.0000000
## V3_8 0.3448310 0.2615373 0.2993925 0.7969701 0.5905416 0.5367638 0.4091348
## V3_9 0.5008717 0.4234479 0.5214417 0.4845284 0.8332242 0.7558601 0.5122129
## V3_8 V3_9
## V3_1 0.3448310 0.5008717
## V3_2 0.2615373 0.4234479
## V3_3 0.2993925 0.5214417
## V3_4 0.7969701 0.4845284
## V3_5 0.5905416 0.8332242
## V3_6 0.5367638 0.7558601
## V3_7 0.4091348 0.5122129
## V3_8 1.0000000 0.5849937
## V3_9 0.5849937 1.0000000Mit corrplot() aus dem Paket corrplot lassen sich Korrelationen grafisch darstellen. order = "hclust" ordnet die Items nach einer hierarchischen Clusterung ihrer Zusammenhänge an. Zusammenhängende farbige Bereiche können auf Gruppen ähnlich beantworteter Items hinweisen.
library(corrplot) #ggf. ## corrplot 0.95 loadedcorrplot(cor(data[1:9]), order="hclust") 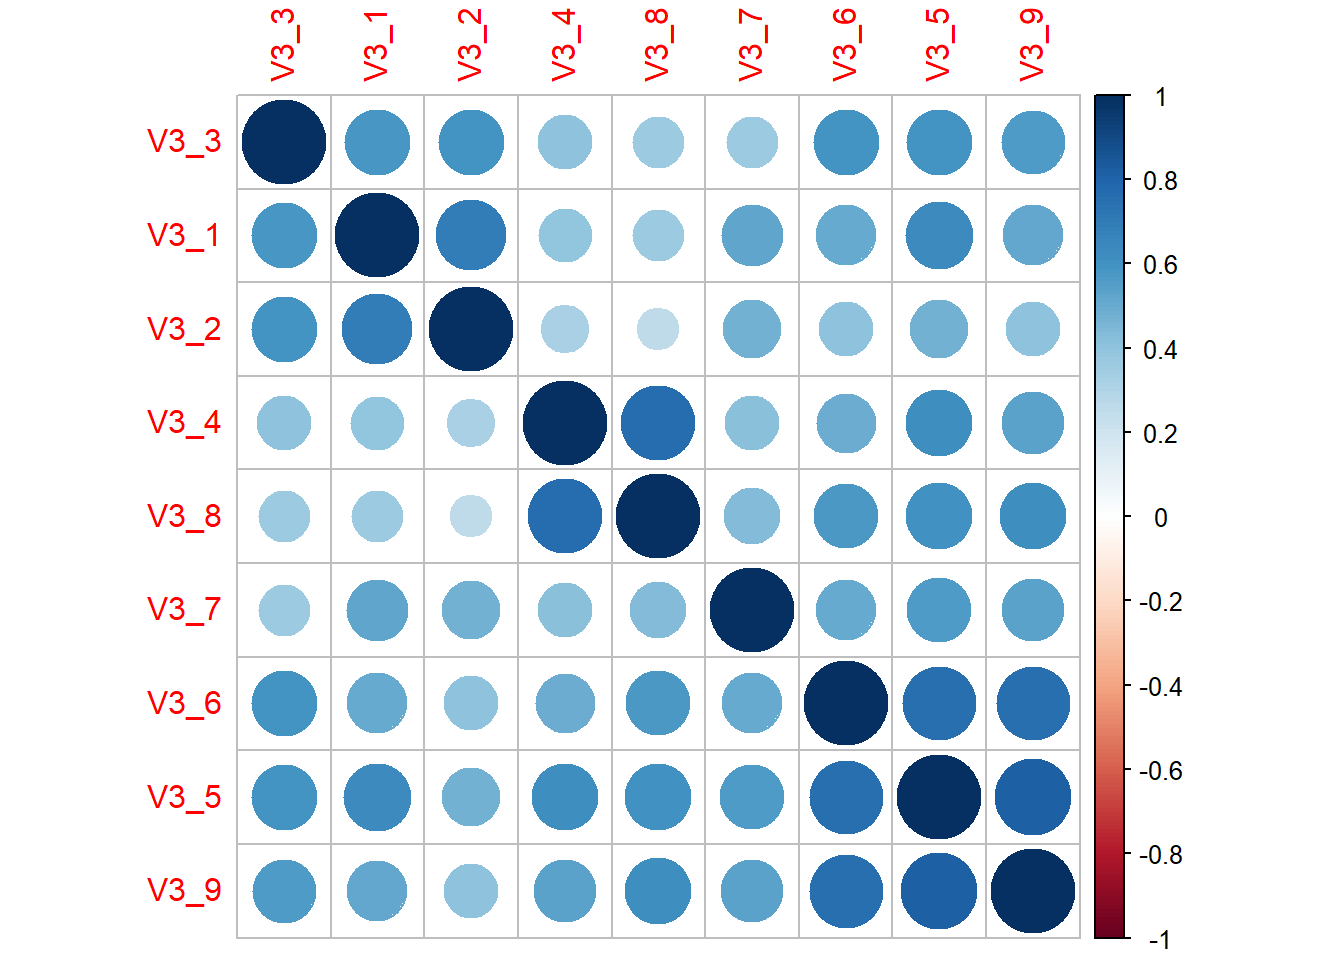
Mit dem Paket PerformanceAnalytics lassen sich Korrelationen visuell und bezüglich der Signifikanz anschaulich darstellen.
library(PerformanceAnalytics)#(ggf. vorher installieren mit install.packages())Besser ist ein chart.Correlation Plot. Der zeigt nicht nur die Korrelationen, sondern auch die Verteilung, den xyPplot und die Signifikanz der Korrelationen.
data[,1:9]%>% # Alternativ anstatt 1:9 geht auch c(1,2,3,4,...9)
  chart.Correlation()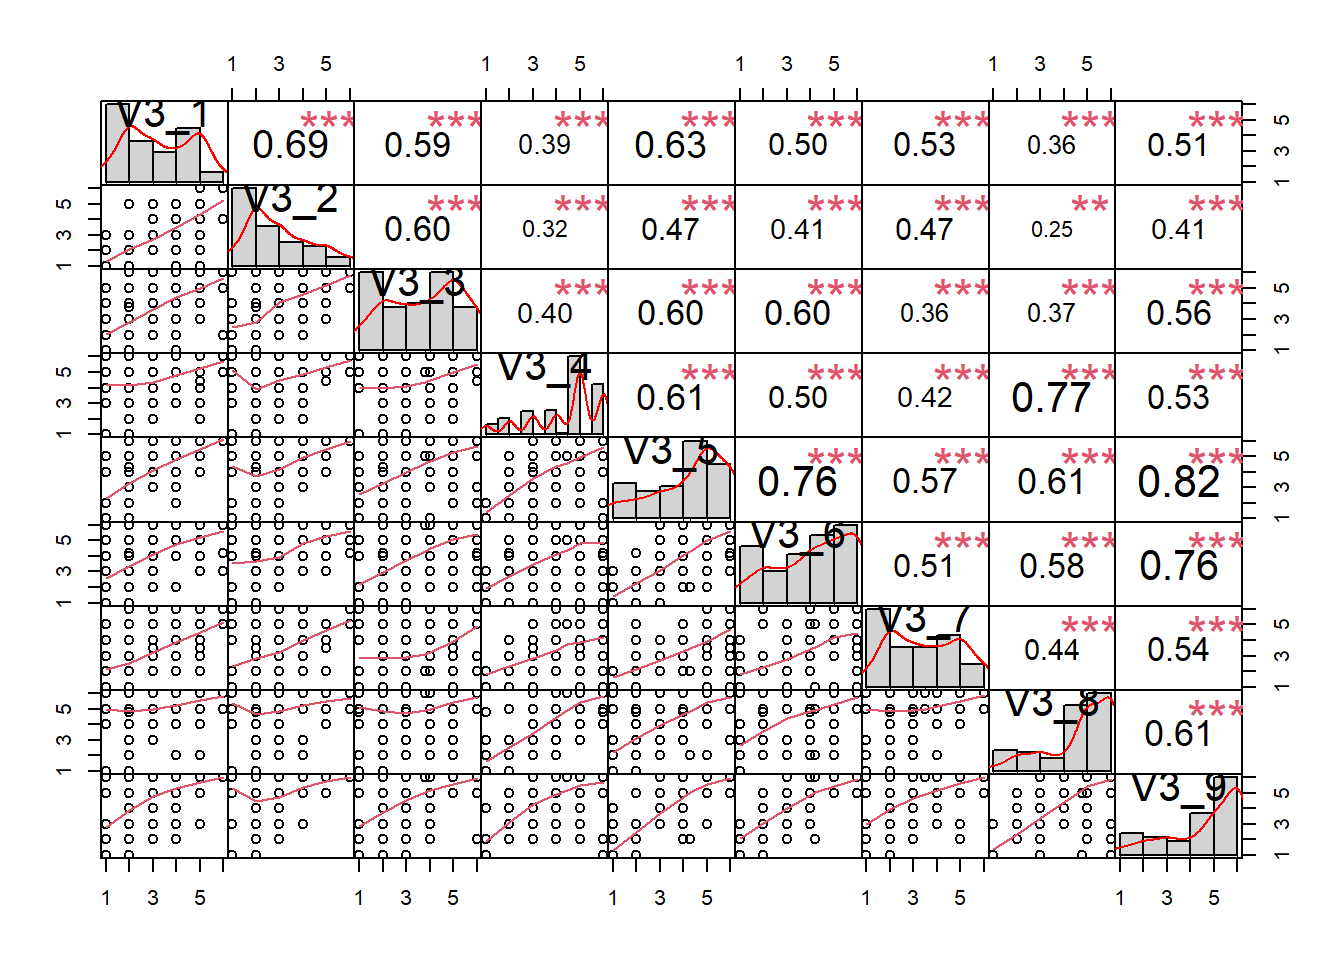
# chart.Correlation(data[,1:9]) Alternativ ohne PfeifePearsons r beschreibt Richtung und Stärke eines linearen Zusammenhangs und liegt zwischen −1 und +1. Negative Werte zeigen einen gegenläufigen Zusammenhang. Eine allgemeine Grenze bei r = 0,5 für das Vorliegen eines Zusammenhangs gibt es nicht. Effektgröße, Unsicherheit, Stichprobengröße und fachliche Relevanz werden gemeinsam beurteilt. Ein Wert nahe null schließt zudem einen nichtlinearen Zusammenhang nicht aus.
6 Dimensionsreduktion (Ausführlicher bei Dimensionsreduktion)
Pakete laden
library(nFactors) #(ggf. vorher installieren mit install.packages())
library(ltm) # für Alpha #(ggf. vorher installieren mit install.packages())
library(psych) #(ggf. vorher installieren mit install.packages())
6.1 Screeplot
Der Screeplot mit VSS.scree() stellt die Eigenwerte der Komponenten dar. Das Kaiser-Kriterium berücksichtigt bei einer Analyse der Korrelationsmatrix Eigenwerte größer als 1. Es ist eine Faustregel, keine zwingende Auswahlvorschrift. Zusätzlich sollten Screeplot, inhaltliche Interpretierbarkeit und möglichst eine Parallelanalyse betrachtet werden.
VSS.scree(data[1:9])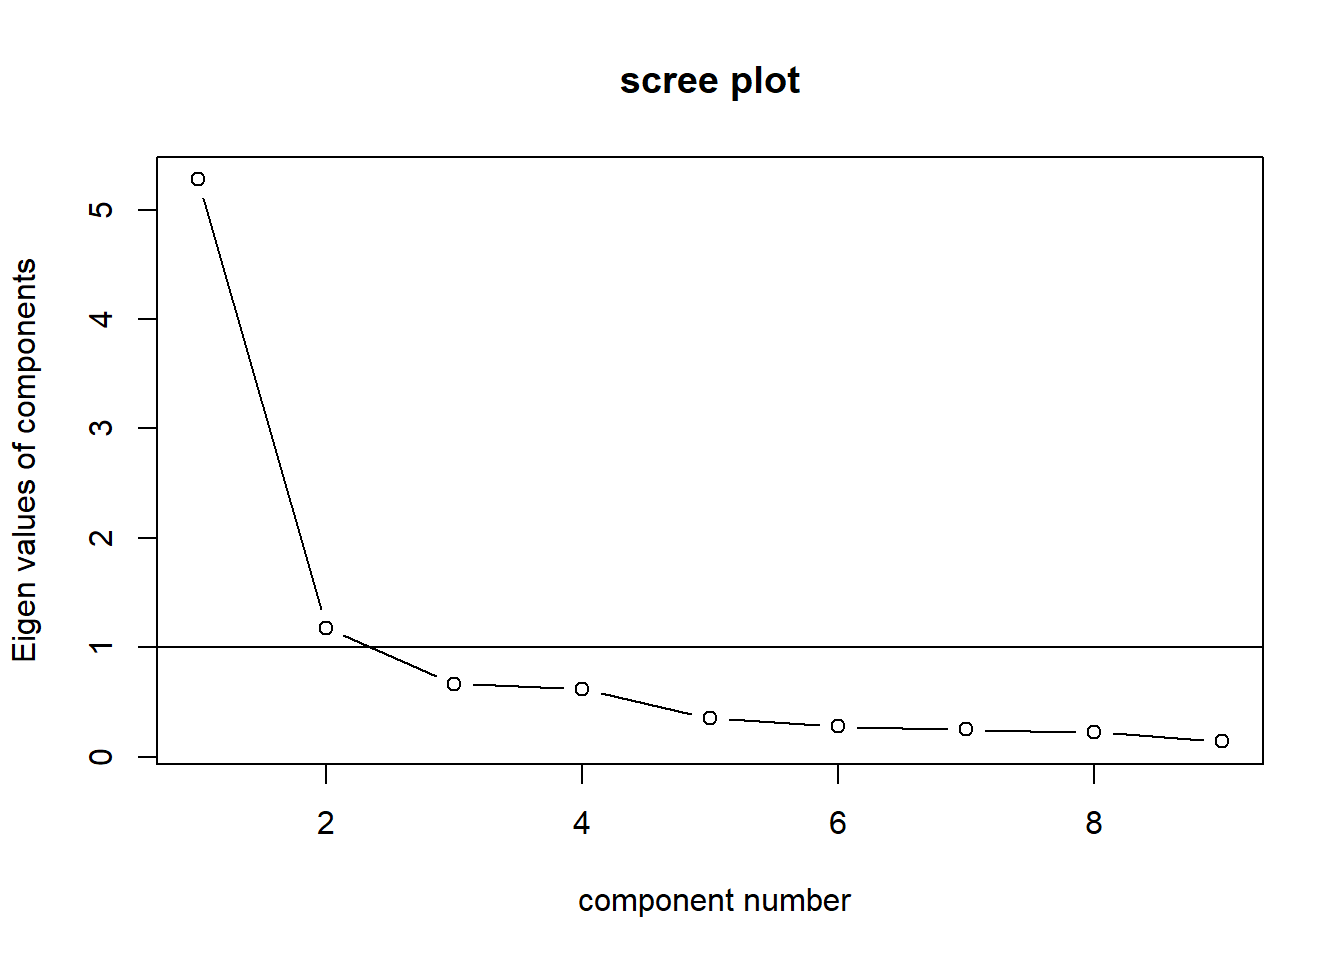 Für dieses Lehrbeispiel untersuchen wir eine Lösung mit zwei Komponenten. Farbgruppen in einer Korrelationsgrafik sind noch keine geschätzten Komponenten. Die Entscheidung für die Anzahl wird mit den Ergebnissen der Dimensionsprüfung und dem Untersuchungsziel begründet.
6.2 PCA (Principal component analysis = Hauptkomponentenanalyse)
Mit principal() werden hier zwei Komponenten geschätzt. Die Anzahl wird mit nfactors = 2 festgelegt. Die standardmäßige Varimax-Rotation erleichtert die Interpretation; die mit RC bezeichneten Größen sind rotierte Komponenten.
pca<-principal(data[1:9], 2) # hier nicht vergessen die Anzahl Komponenten einzutragen
print(pca, cut=0.4, sort=TRUE)
## Principal Components Analysis
## Call: principal(r = data[1:9], nfactors = 2)
## Standardized loadings (pattern matrix) based upon correlation matrix
## item RC1 RC2 h2 u2 com
## V3_2 2 0.85 0.73 0.27 1.0
## V3_1 1 0.82 0.72 0.28 1.1
## V3_3 3 0.78 0.65 0.35 1.1
## V3_6 6 0.60 0.59 0.71 0.29 2.0
## V3_7 7 0.51 0.44 0.45 0.55 2.0
## V3_8 8 0.91 0.84 0.16 1.0
## V3_4 4 0.86 0.76 0.24 1.0
## V3_5 5 0.58 0.67 0.79 0.21 2.0
## V3_9 9 0.53 0.67 0.73 0.27 1.9
##
## RC1 RC2
## SS loadings 3.27 3.10
## Proportion Var 0.36 0.34
## Cumulative Var 0.36 0.71
## Proportion Explained 0.51 0.49
## Cumulative Proportion 0.51 1.00
##
## Mean item complexity = 1.5
## Test of the hypothesis that 2 components are sufficient.
##
## The root mean square of the residuals (RMSR) is 0.05
## with the empirical chi square 23.67 with prob < 0.21
##
## Fit based upon off diagonal values = 0.99Die Zeile Proportion Var zeigt die Varianzanteile der rotierten Komponenten; Cumulative Var enthält ihren kumulierten Anteil. Im berechneten Beispiel erfassen die beiden Komponenten zusammen 70.8 % der Gesamtvarianz. Eine allgemeingültige Mindestgrenze von 50 % gibt es nicht. Die Bewertung hängt vom Ziel der Analyse, den Items und der Interpretierbarkeit ab.
Merke: Ziel der Dimensionsreduktion ist immer die Variablen auf so wenig wie möglich Komponenten zu reduzieren aber gleichzeitig so viel Streuung wie möglich zu erklären.
Die Zahlen unter RC1 und RC2 nennt man Ladungen. Eine Ladung ist die Korrelation zur Komponente.
Achtung: Im Beispiel betrachten wir zusätzlich eine Lösung ohne V3_7. Das Item zeigt in der ersten Lösung eine Kreuzladung; die tatsächlichen Werte stehen in der Ausgabe. Ein Ausschluss braucht eine Begründung aus dem Iteminhalt und der Messabsicht. Ladungsgrenzen allein ersetzen diese Begründung nicht.
Deswegen wiederholen wir die PCA (Idealerweise sogar den Screeplot):
VSS.scree(data[c(1:6,8:9)])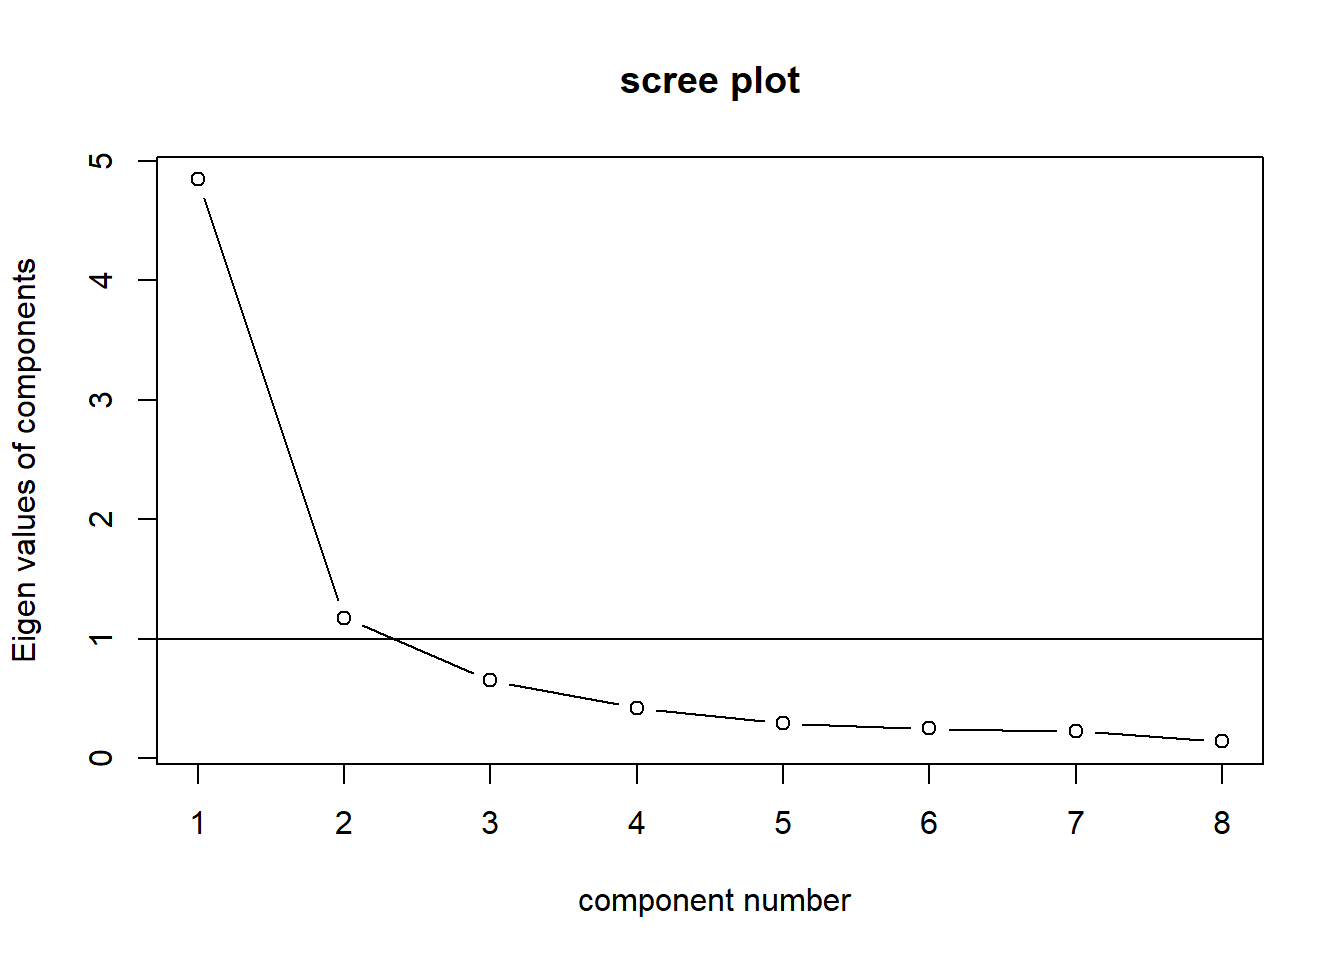
pca<-principal(data[c(1:6,8:9)], 2) # hier nicht vergessen die Anzahl Komponenten einzutragen
print(pca, cut=0.6, sort=TRUE)
## Principal Components Analysis
## Call: principal(r = data[c(1:6, 8:9)], nfactors = 2)
## Standardized loadings (pattern matrix) based upon correlation matrix
## item RC1 RC2 h2 u2 com
## V3_2 2 0.85 0.73 0.27 1.0
## V3_1 1 0.81 0.71 0.29 1.1
## V3_3 3 0.80 0.69 0.31 1.1
## V3_6 6 0.71 0.29 2.0
## V3_8 7 0.91 0.84 0.16 1.0
## V3_4 4 0.87 0.76 0.24 1.0
## V3_5 5 0.68 0.80 0.20 2.0
## V3_9 8 0.67 0.73 0.27 1.9
##
## RC1 RC2
## SS loadings 3.02 2.95
## Proportion Var 0.38 0.37
## Cumulative Var 0.38 0.75
## Proportion Explained 0.51 0.49
## Cumulative Proportion 0.51 1.00
##
## Mean item complexity = 1.4
## Test of the hypothesis that 2 components are sufficient.
##
## The root mean square of the residuals (RMSR) is 0.06
## with the empirical chi square 19.88 with prob < 0.098
##
## Fit based upon off diagonal values = 0.99Nach Ausschluss des diskutierten Items werden acht Items durch zwei rotierte Komponenten zusammengefasst. Ihr kumulierter Varianzanteil beträgt hier 74.6 %. Ein Ausschluss darf nicht nur einer günstigeren Kennzahl dienen.
Anschließend untersuchen wir die interne Konsistenz der vorgesehenen Itemskalen. Cronbachs Alpha bezieht sich auf Skalenwerte, nicht auf einen Beweis der Validität eines Konstrukts. Ein Wert um 0,7 wird häufig als Orientierung verwendet; seine Angemessenheit hängt unter anderem von Itemzahl, Verwendungszweck und Messmodell ab.
6.3 Was ist ein Cronbach’s Alpha?
6.3.1 Interne Konsistenz der Skalen
Das einfachste Maß für die interne Konsistenz ist die Split-Half-Reliabilität. Die Items werden in zwei Hälften unterteilt und die resultierenden Scores sollten in ihren Kenngrößen ähnlich sein. Hohe Korrelationen zwischen den Hälften deuten auf eine hohe interne Konsistenz hin. Das Problem ist, dass die Ergebnisse davon abhängen, wie die Items aufgeteilt werden. Ein üblicher Ansatz zur Lösung dieses Problems besteht darin, den Koeffizienten Alpha (Cronbachs Alpha) zu verwenden.
6.3.2 Cronbachs Alpha
Cronbachs Alpha ist ein Maß für die interne Konsistenz einer Itemskala. Seine Interpretation als Reliabilitätsschätzung hängt von Voraussetzungen des Messmodells ab. Hohe Werte beweisen weder Eindimensionalität noch Validität. Ein geschätzter Wert kann bei problematischen Itemzusammenhängen auch negativ sein, etwa bei einer fehlerhaften Kodierung. Schwellen sind deshalb im fachlichen Kontext zu verwenden, nicht als automatische Entscheidung über die Qualität einer Skala.
cronbach.alpha(data[1:3]) ##
## Cronbach's alpha for the 'data[1:3]' data-set
##
## Items: 3
## Sample units: 112
## alpha: 0.823cronbach.alpha(data[c(4:6,8,9)]) ##
## Cronbach's alpha for the 'data[c(4:6, 8, 9)]' data-set
##
## Items: 5
## Sample units: 112
## alpha: 0.897Die Ausgaben enthalten die für diesen Datensatz geschätzten Alpha-Werte. Sie werden zusammen mit der Itemstruktur und dem Verwendungszweck der Skalen beurteilt.
Wann wird ein Item aus der weiteren Analyse ausgeschlossen? Antwort: Ein Ausschluss braucht eine inhaltliche und messtheoretische Begründung. Iteminhalt, Kodierung, Zusammenhänge und Folgen für die Abdeckung des Konstrukts werden gemeinsam geprüft. Eine Erhöhung von Alpha allein rechtfertigt keinen Ausschluss.
Fragestellung: Lassen sich die Komponenten gut inhaltlich interpretieren, und wie sollen Komponenten heißen?
RC1 kann zusammengefasst werden als Erschöpfung und RC2 als Stress
6.3.3 Bildung der Skalenmittelwerte Erschöpfung und Stress
Mit rowMeans() bilden wir gleichgewichtete Skalenmittelwerte für Erschöpfung und Stress. Diese sind nicht identisch mit den gewichteten Komponentenwerten einer PCA. Die vorherigen Analysen unterstützen die Beurteilung der Itemstruktur; die gemeinsame Zusammenfassung der Items braucht zusätzlich eine inhaltliche Begründung. Für die folgenden Beispiele verwenden wir Skalenmittelwerte.
data$Erschoepft<-rowMeans(data[1:3], na.rm = TRUE)
data$Stress<-rowMeans(data[c(4:6,8,9)], na.rm = TRUE)
t(colnames(data))
## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22] [,23]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss" "Erschoepft"
## [,24]
## [1,] "Stress"Umbenennung von Variablen
data$Erschoepfung<-data$Erschoepft #Variable unter neuem Namen speichern
data$Erschoepft<-NULL # Alte Variable löschen
t(colnames(data))
## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22] [,23]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss" "Stress"
## [,24]
## [1,] "Erschoepfung"#oder so wie oben:
#names(data)[24] <- c("Erschoepfung")6.3.4 Überprüfung der Struktur für Gesundheit und Bildung des Konstrukts
t(colnames(data))## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22] [,23]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss" "Stress"
## [,24]
## [1,] "Erschoepfung"corrplot(cor(data[11:20]), order="hclust")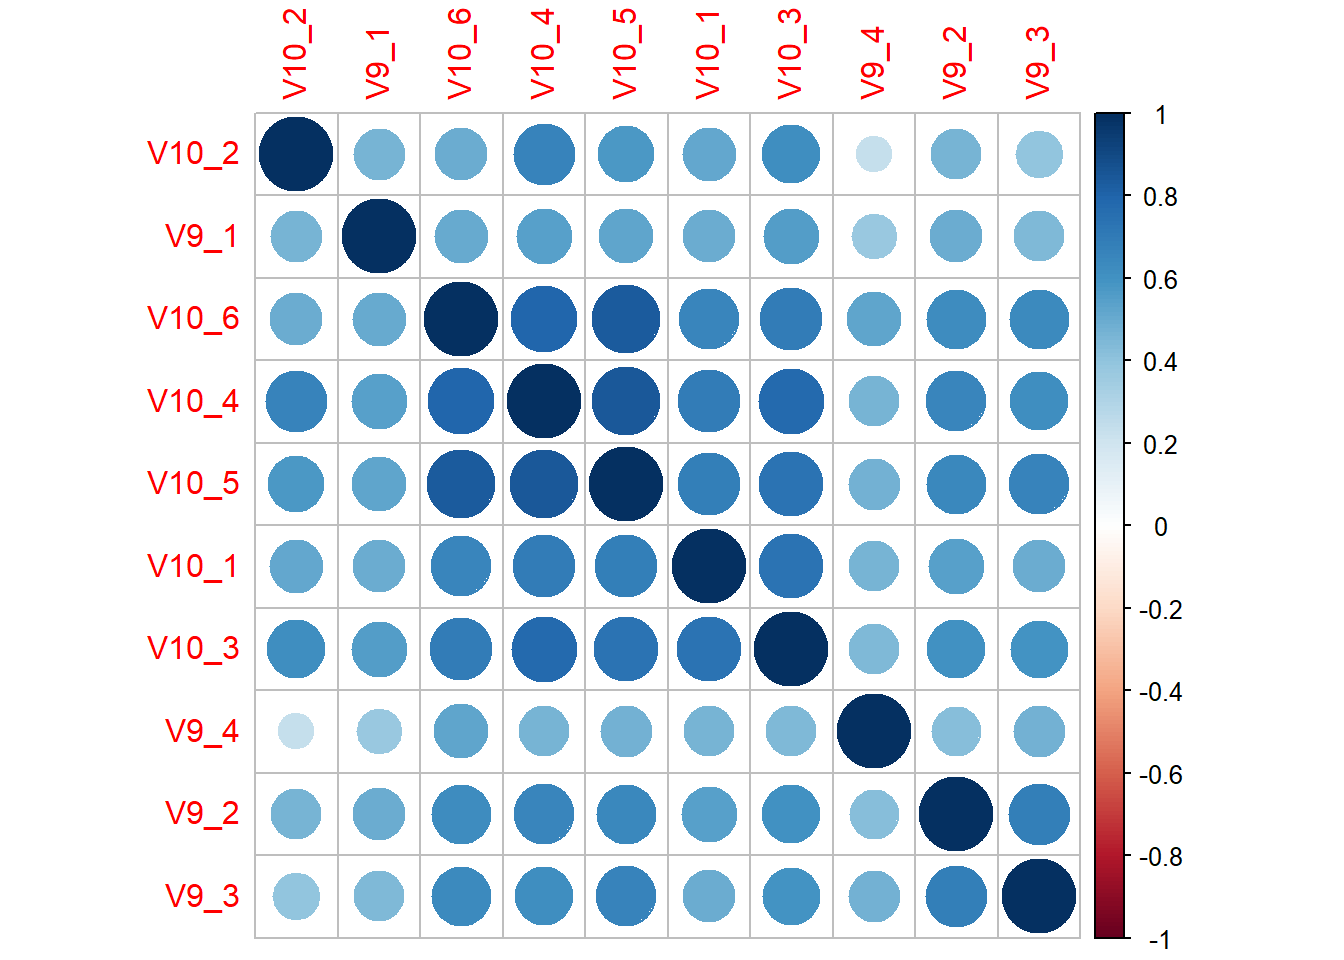
VSS.scree(data[11:20])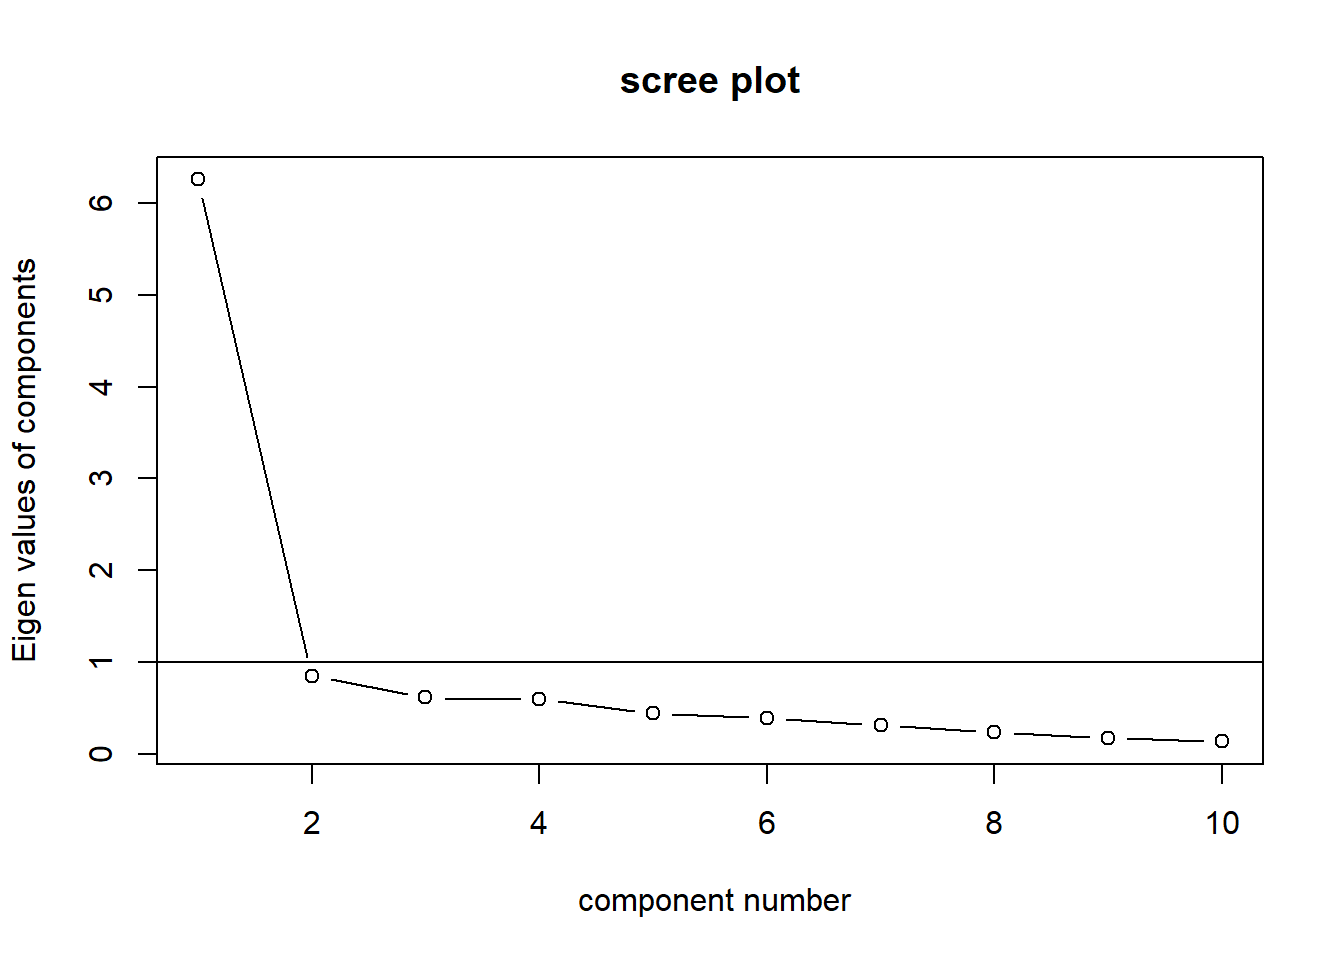
pca<-principal(data[11:20], 1) # hier nicht vergessen die Anzahl Komponenten einzutragen
print(pca, cut=0.4, sort=TRUE)
## Principal Components Analysis
## Call: principal(r = data[11:20], nfactors = 1)
## Standardized loadings (pattern matrix) based upon correlation matrix
## V PC1 h2 u2 com
## V10_4 8 0.92 0.84 0.16 1
## V10_5 9 0.89 0.80 0.20 1
## V10_3 7 0.88 0.77 0.23 1
## V10_6 10 0.87 0.76 0.24 1
## V10_1 5 0.79 0.63 0.37 1
## V9_3 3 0.76 0.57 0.43 1
## V9_2 2 0.76 0.57 0.43 1
## V10_2 6 0.65 0.42 0.58 1
## V9_1 1 0.63 0.40 0.60 1
## V9_4 4 0.58 0.34 0.66 1
##
## PC1
## SS loadings 6.10
## Proportion Var 0.61
##
## Mean item complexity = 1
## Test of the hypothesis that 1 component is sufficient.
##
## The root mean square of the residuals (RMSR) is 0.05
## with the empirical chi square 21.49 with prob < 0.96
##
## Fit based upon off diagonal values = 0.99cronbach.alpha(data[c(11:20)]) ##
## Cronbach's alpha for the 'data[c(11:20)]' data-set
##
## Items: 10
## Sample units: 112
## alpha: 0.926data$Gesundheit<-rowMeans(data[11:20], na.rm = TRUE)
t(colnames(data))## [,1] [,2] [,3] [,4] [,5] [,6] [,7] [,8] [,9]
## [1,] "V3_1" "V3_2" "V3_3" "V3_4" "V3_5" "V3_6" "V3_7" "V3_8" "V3_9"
## [,10] [,11] [,12] [,13] [,14] [,15] [,16] [,17]
## [1,] "Berufliche.Belastung" "V9_1" "V9_2" "V9_3" "V9_4" "V10_1" "V10_2" "V10_3"
## [,18] [,19] [,20] [,21] [,22] [,23]
## [1,] "V10_4" "V10_5" "V10_6" "Geschlecht" "Bildungsabschluss" "Stress"
## [,24] [,25]
## [1,] "Erschoepfung" "Gesundheit"7 Voraussetzung für eine barrierefreie Datenanalyse.
=> alle Schritte bis hierher durchführen:
- Die Daten müssen richtig klassifiziert sein.
- Die Konstrukte müssen über z. B. Mittelwertbildung gebildet sein.
8 Daten skalieren.
=> Verweis auf Skript Dimensionsreduktion
Der Befehl lautet scale(). Mit dem Befehl kann entweder einen ganze Datenmatrix oder nur eine Auswahl von Variablen skaliert werden. Dies ist dann notwendig, wenn Daten unterschiedlich skaliert sind.
9 Grundlagen der Inferenzstatistik (Kurze Wiederholung aus dem Studium: Was ist wirklich relevant, um die Inferenz zu verstehen!
Warum testen wir Hypothesen? Poppers Falsifikationsansatz fordert, theoretische Vorhersagen kritisch mit Daten zu prüfen. Statistische Tests führen zu Entscheidungen unter Unsicherheit und sind keine sicheren logischen Widerlegungen. Die Grundlagen erklärt Wissenschaftstheorie: Hypothesen prüfen mit Popper.
Was ist ein p-value?
p-value = Wahrscheinlichkeit, unter der Nullhypothese und den Annahmen des gewählten Tests eine mindestens so extreme Teststatistik wie die beobachtete zu erhalten. Der p-Wert ist nicht die Wahrscheinlichkeit, dass die Nullhypothese wahr ist, und misst nicht die Größe oder praktische Bedeutung eines Effekts.
Forschungshypothese: Eine theoretisch begründete Vorhersage über den Untersuchungsgegenstand. Nullhypothese: Die im statistischen Test zu prüfende Aussage, zum Beispiel „Es gibt keinen Unterschied“. Ihre Form hängt von der Fragestellung und vom Testverfahren ab.
Übliche Kennzeichnungen statistischer Signifikanz:
- n.s.: Nicht signifikant
- 0,10: Zum 10 Prozent Niveau signifikant
- 0,05: zum 5 Prozent Niveau signifikant
- 0,01: zum 1 Prozent Niveau signifikant
- 0,001: zum 0,1 Prozent Niveau signifikant
Achtung: Signifikanz heißt nicht Repräsentativität!!!!
Für die Darstellung in der Arbeit: Die Forschungshypothesen stehen im Mittelpunkt. Das statistische Prüfverfahren und die Entscheidungsregeln müssen nachvollziehbar beschrieben werden. Das Verwerfen einer Nullhypothese beweist die Forschungshypothese nicht; das Nichtverwerfen beweist auch nicht die Abwesenheit eines Effekts.
9.1 Test auf Normalverteilung
Test für alle drei Konstrukte
shapiro.test(data$Stress)##
## Shapiro-Wilk normality test
##
## data: data$Stress
## W = 0.89964, p-value = 4.073e-07shapiro.test(data$Erschoepfung)##
## Shapiro-Wilk normality test
##
## data: data$Erschoepfung
## W = 0.96708, p-value = 0.007271shapiro.test(data$Gesundheit)##
## Shapiro-Wilk normality test
##
## data: data$Gesundheit
## W = 0.94749, p-value = 0.0002452Der Shapiro-Wilk-Test untersucht die Vereinbarkeit der beobachteten Werte mit einer Normalverteilung. Ein kleiner p-Wert spricht gegen diese Annahme. Bei größeren Stichproben kann der Test auch geringe, praktisch wenig bedeutsame Abweichungen erkennen. Zusätzlich werden Q-Q-Plots und Ausreißer betrachtet.
Zentraler Grenzwertsatz: Unter geeigneten Voraussetzungen kann die Verteilung des standardisierten Stichprobenmittelwerts bei hinreichend großem n näherungsweise normal sein. Die Rohdaten werden dadurch nicht normalverteilt. Eine feste Grenze von n > 30 ist keine allgemeine Garantie. Bei Regression und ANOVA beziehen sich die üblichen Normalitätsannahmen auf die Fehler beziehungsweise Residuen, nicht auf alle Variablen des gesamten Datensatzes.
9.2 Korrelationstest
corr.test(data$Stress, data$Gesundheit)## Call:corr.test(x = data$Stress, y = data$Gesundheit)
## Correlation matrix
## [1] 0.74
## Sample Size
## [1] 112
## These are the unadjusted probability values.
## The probability values adjusted for multiple tests are in the p.adj object.
## [1] 0
##
## To see confidence intervals of the correlations, print with the short=FALSE optionschöner
data[,c("Stress", "Gesundheit")]%>%
  chart.Correlation()
## Warning in par(usr): argument 1 does not name a graphical parameter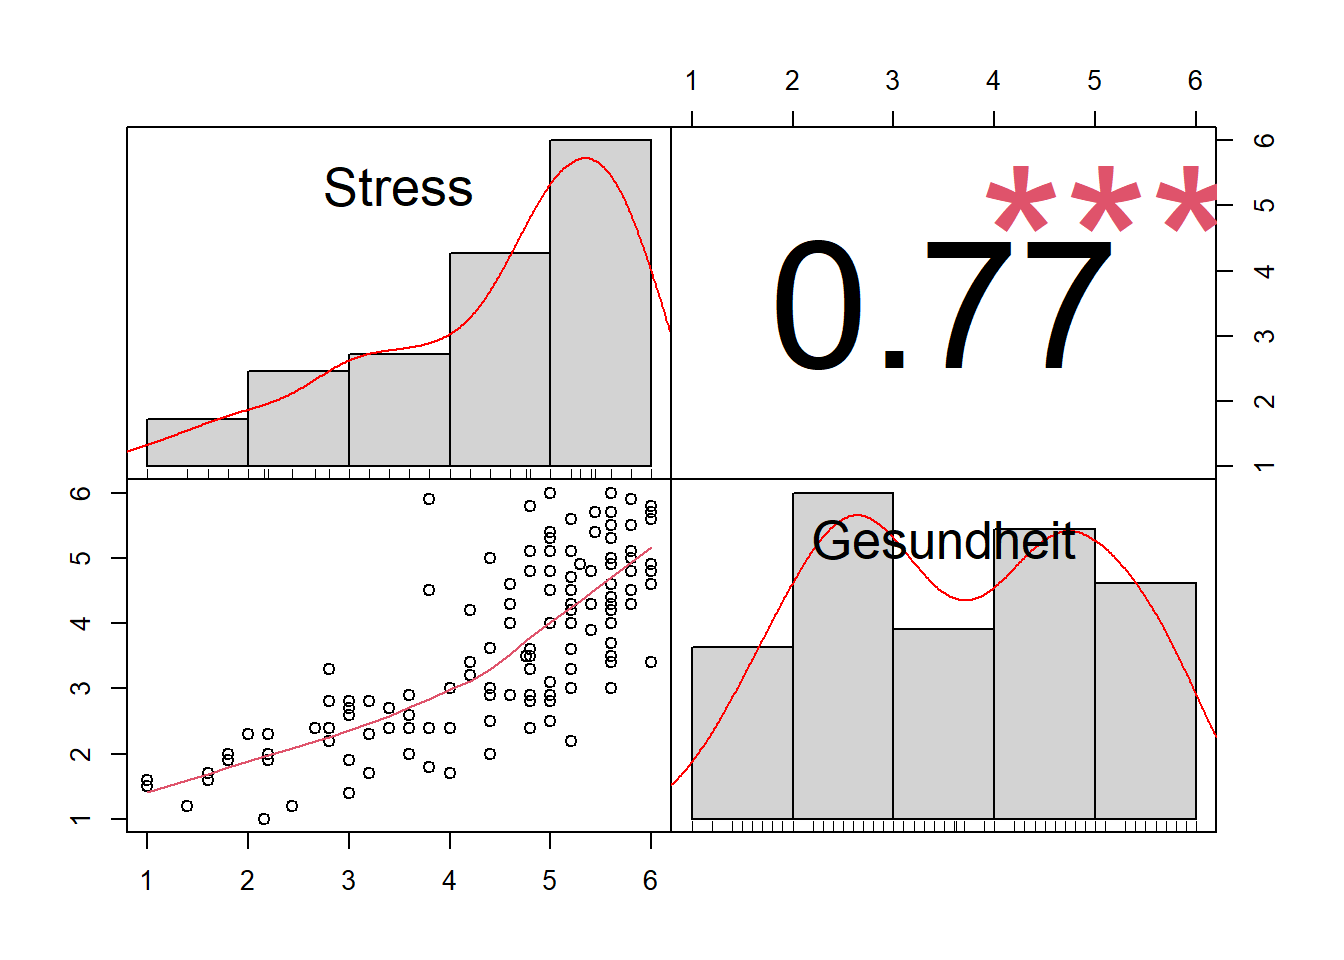
9.3 Lineare multiple Regressionsanalyse
Forschungshypothese: Höhere Stress- und Erschöpfungswerte gehen mit stärkeren gesundheitlichen Beschwerden einher. Im Beispiel bedeuten höhere Werte der Variable Gesundheit mehr Beschwerden; die Richtung der Kodierung ist bei der Interpretation zu berücksichtigen.
Anwendung: Bei der linearen Regressionsanalyse wird der Einfluss einer metrischen oder kategorialen unabhängige Variablen auf eine metrische abhängige Variable geprüft.
Wird oft als Hypothese so formuliert: Wenn….dann… Bsp.: wenn Stress, dann ungesund.
model<-lm(Gesundheit~Stress , data=data)
summary(model)
##
## Call:
## lm(formula = Gesundheit ~ Stress, data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -2.02117 -0.60117 0.05512 0.55311 2.77483
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) 0.15033 0.31684 0.474 0.636
## Stress 0.78285 0.06748 11.601 <2e-16 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.8852 on 110 degrees of freedom
## Multiple R-squared: 0.5502, Adjusted R-squared: 0.5462
## F-statistic: 134.6 on 1 and 110 DF, p-value: < 2.2e-16model<-lm(Gesundheit~Erschoepfung, data=data)
summary(model)##
## Call:
## lm(formula = Gesundheit ~ Erschoepfung, data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -1.7613 -0.5863 -0.1269 0.5674 3.0306
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) 1.06203 0.24673 4.304 3.65e-05 ***
## Erschoepfung 0.78445 0.06904 11.362 < 2e-16 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.8953 on 110 degrees of freedom
## Multiple R-squared: 0.5399, Adjusted R-squared: 0.5358
## F-statistic: 129.1 on 1 and 110 DF, p-value: < 2.2e-16model<-lm(Gesundheit~Stress + Erschoepfung, data=data)
summary(model)##
## Call:
## lm(formula = Gesundheit ~ Stress + Erschoepfung, data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -1.56180 -0.45613 -0.05318 0.42763 2.28571
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) -0.16378 0.27279 -0.600 0.549
## Stress 0.49499 0.07181 6.893 3.71e-10 ***
## Erschoepfung 0.48188 0.07264 6.633 1.31e-09 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.7506 on 109 degrees of freedom
## Multiple R-squared: 0.6796, Adjusted R-squared: 0.6737
## F-statistic: 115.6 on 2 and 109 DF, p-value: < 2.2e-16Im Beispiel zeigen die Koeffizienten die bedingten Zusammenhänge der Beschwerdewerte mit Stress und Erschöpfung. Das Modell erfasst 68 % der beobachteten Varianz. Koeffizienten, Standardfehler und p-Werte stehen in der Ausgabe. Ein beobachteter Zusammenhang in Befragungsdaten beweist für sich genommen keinen kausalen Einfluss.
xyplot(Gesundheit~Stress, data=data)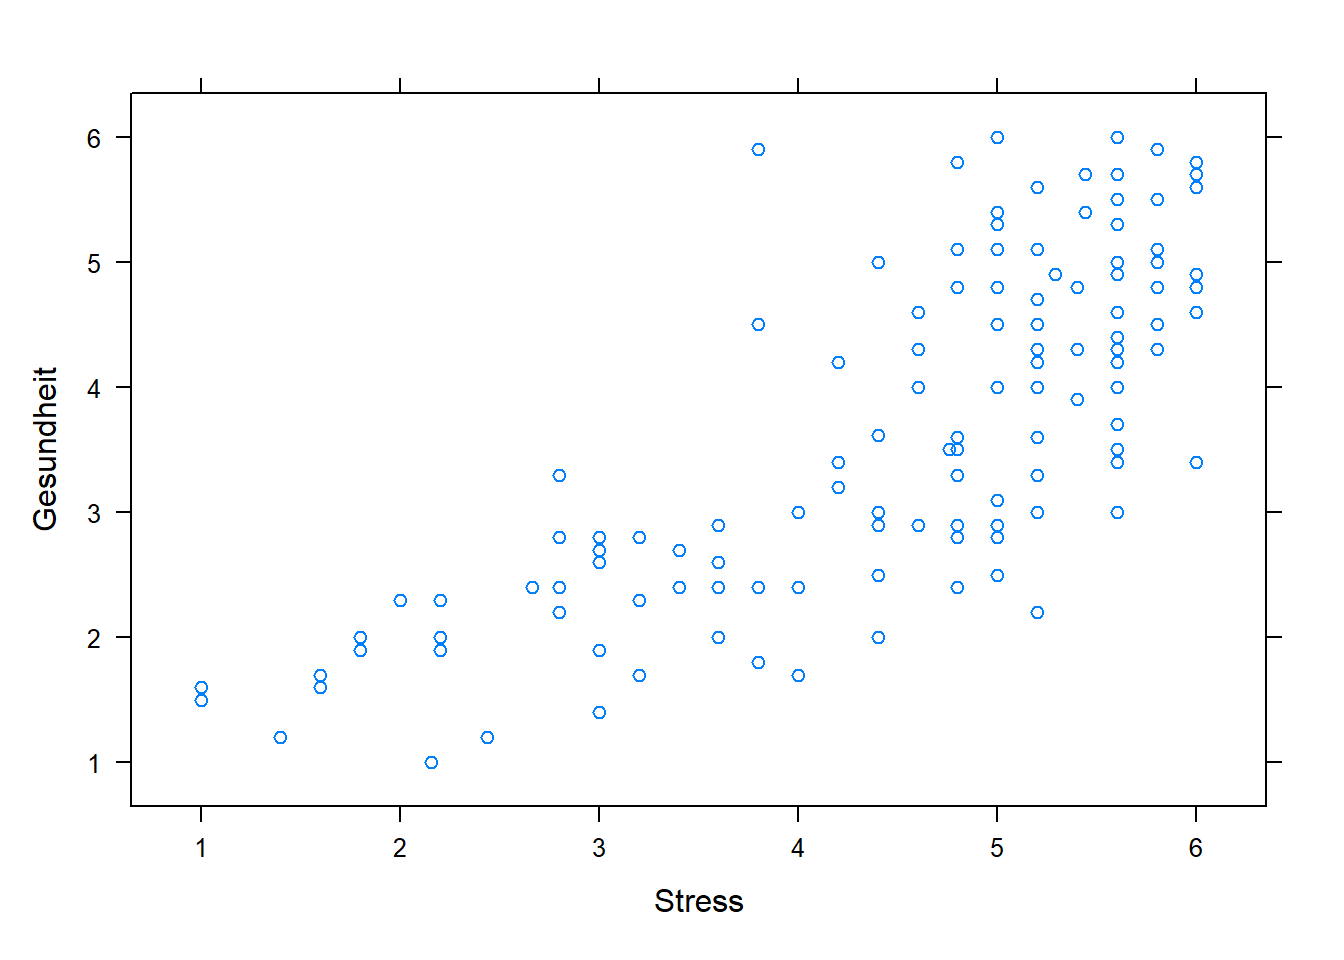
xyplot(Gesundheit~Erschoepfung, data=data)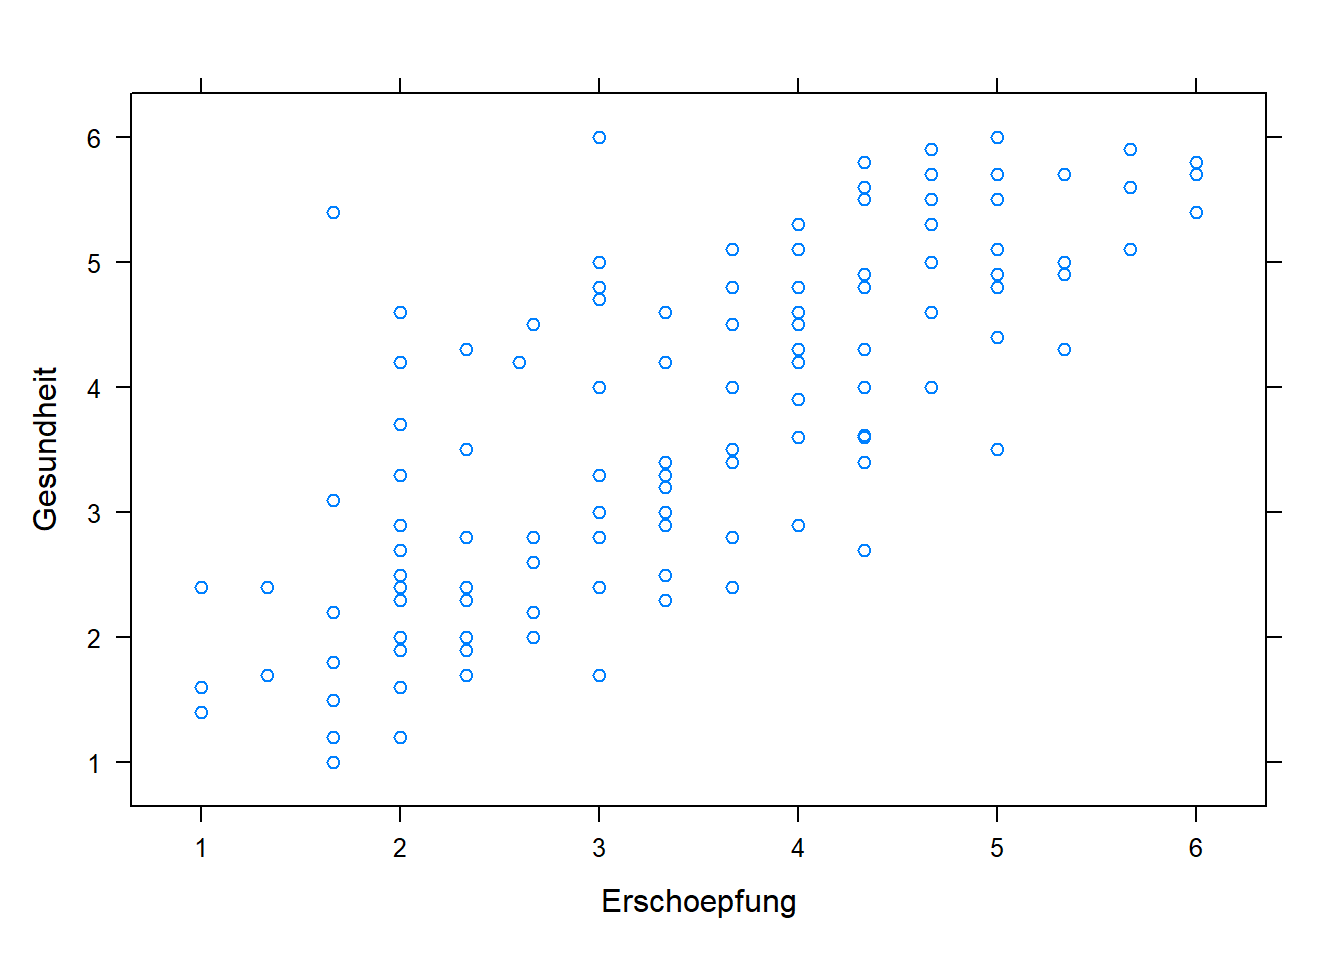
Plot mit einer unabhängigen Variable
model<-lm(Gesundheit~Stress, data=data)
plot(data$Stress, data$Gesundheit, xlab = "Stress", ylab = "Beschwerdewerte")
abline(model, col = "steelblue", lwd = 2)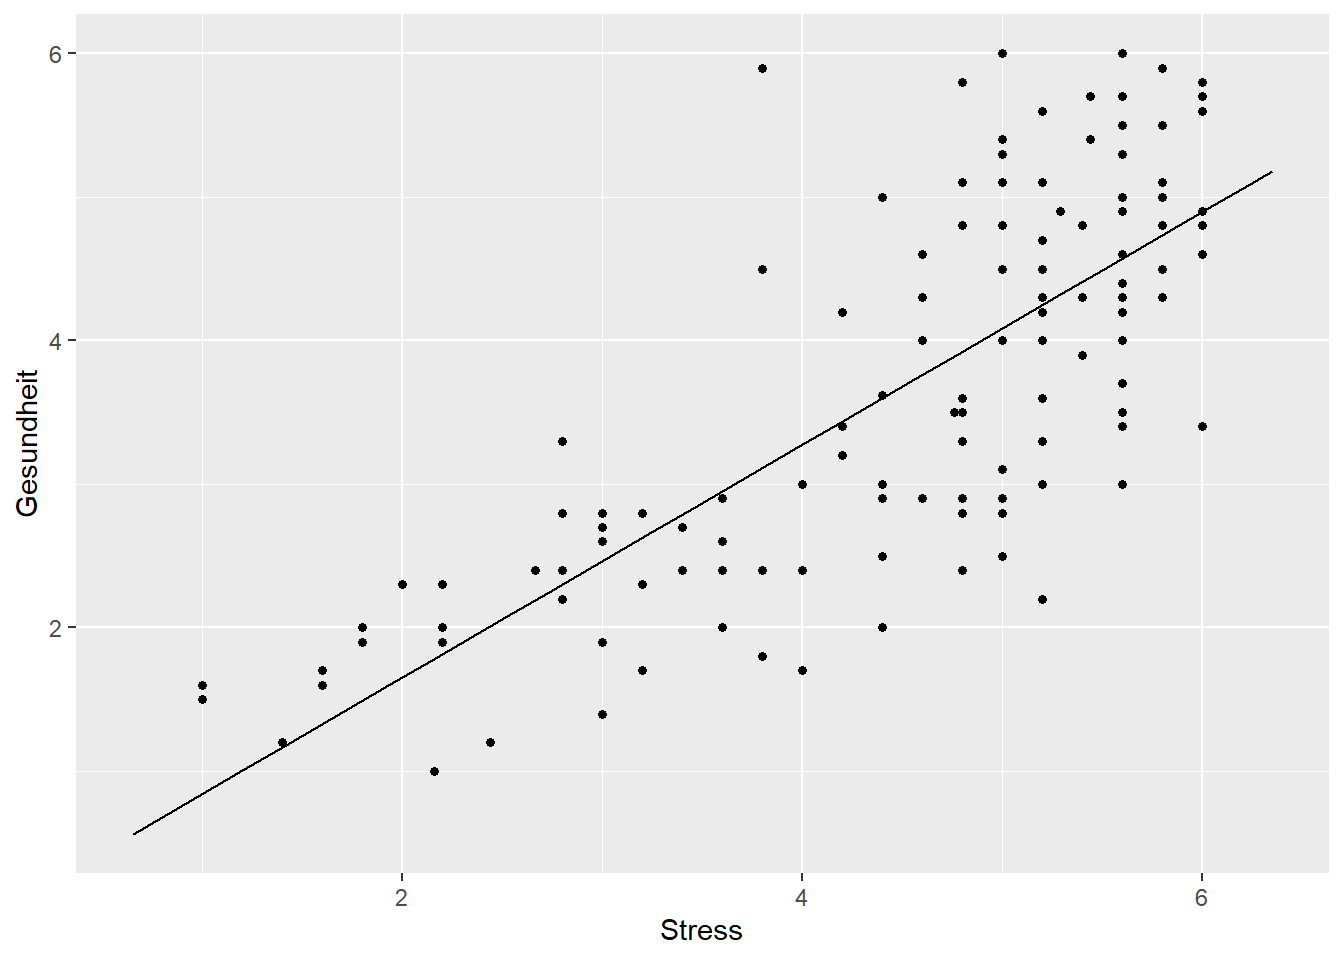
Regressionsausgabe und grafische Darstellung mit dem Paket jtools. Die Koeffiziententabelle wird mit der Standardfunktion summary() ausgegeben:
library(jtools)
summary(model)
##
## Call:
## lm(formula = Gesundheit ~ Stress, data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -2.02117 -0.60117 0.05512 0.55311 2.77483
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) 0.15033 0.31684 0.474 0.636
## Stress 0.78285 0.06748 11.601 <2e-16 ***
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.8852 on 110 degrees of freedom
## Multiple R-squared: 0.5502, Adjusted R-squared: 0.5462
## F-statistic: 134.6 on 1 and 110 DF, p-value: < 2.2e-16effect_plot(model, pred = Stress, interval = TRUE, plot.points = TRUE)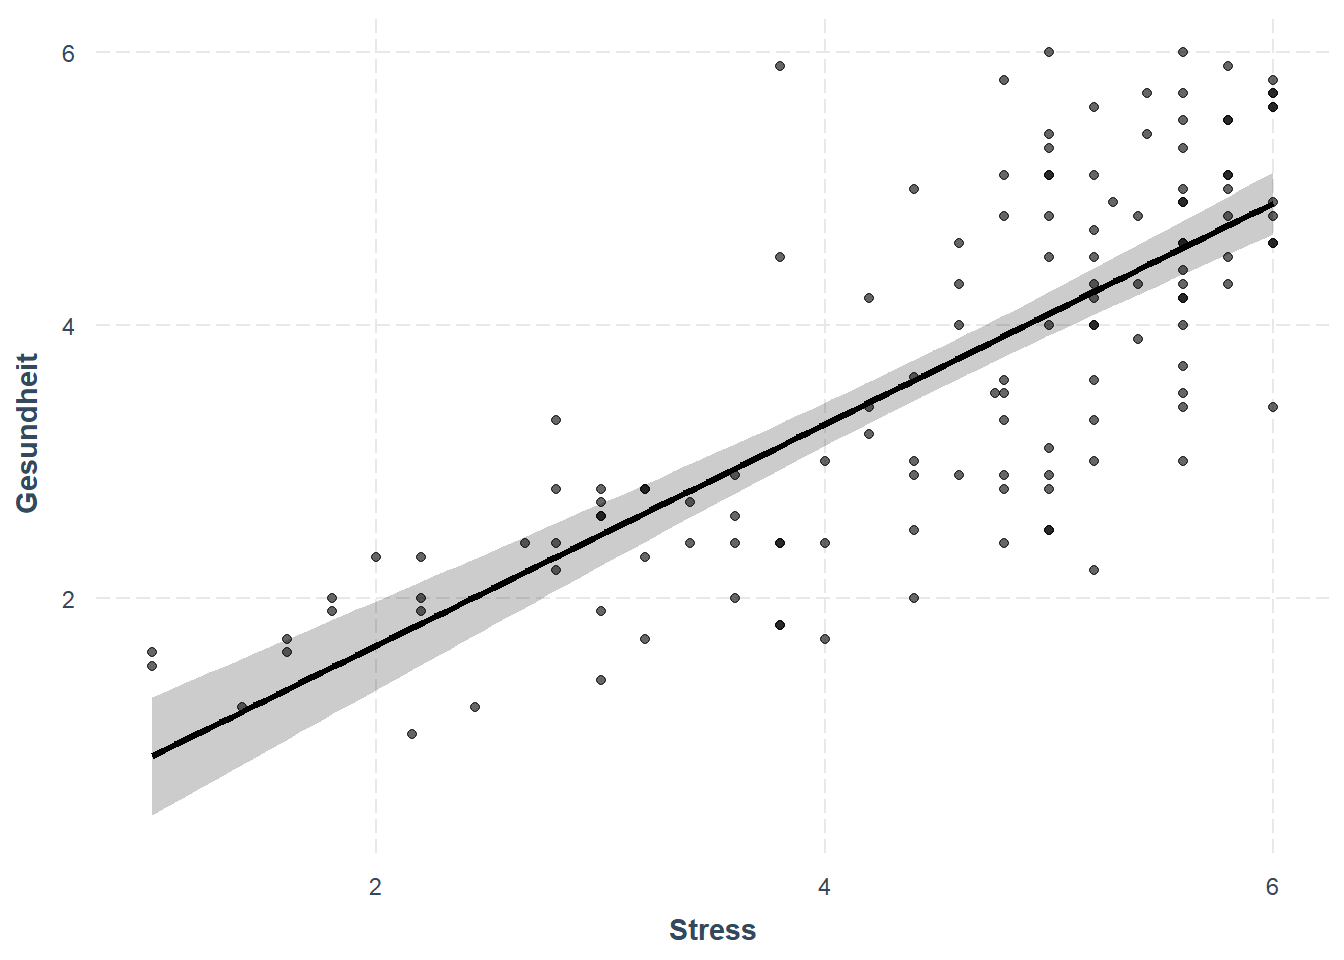
Wie schaut es aus, wenn das Geschlecht noch hinzukomme?
model<-lm(Gesundheit~Stress+Erschoepfung+Geschlecht, data=data)
summary(model)
##
## Call:
## lm(formula = Gesundheit ~ Stress + Erschoepfung + Geschlecht,
## data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -1.44198 -0.47923 -0.08988 0.46060 2.18806
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) -0.29258 0.28490 -1.027 0.307
## Stress 0.49884 0.07147 6.980 2.50e-10 ***
## Erschoepfung 0.47973 0.07226 6.639 1.31e-09 ***
## Geschlechtm<U+00E4>nnlich 0.21075 0.14228 1.481 0.141
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.7465 on 108 degrees of freedom
## Multiple R-squared: 0.686, Adjusted R-squared: 0.6772
## F-statistic: 78.64 on 3 and 108 DF, p-value: < 2.2e-16Für den zusätzlich aufgenommenen Faktor Geschlecht zeigt die Ausgabe den geschätzten Unterschied zur Referenzkategorie unter Kontrolle von Stress und Erschöpfung. Referenzkategorie, vorab festgelegtes Signifikanzniveau sowie Effektgröße und Unsicherheit sind anzugeben. Ein p-Wert zwischen 0,05 und 0,10 ist bei einem festgelegten 5-%-Niveau nicht signifikant.
Gruppenvergleiche mit dem Paket lme4
library(lme4) # ggf. vorher installieren##
## Attaching package: 'lme4'## The following object is masked from 'package:mosaic':
##
## factorizemodel<-lmList(Gesundheit~Stress | Geschlecht, data=data)
summary(model)## Call:
## Model: Gesundheit ~ Stress | Geschlecht
## Data: data
##
## Coefficients:
## (Intercept)
## Estimate Std. Error t value Pr(>|t|)
## weiblich -0.1851548 0.5319994 -0.3480357 0.7284908
## m<U+00E4>nnlich 0.3435767 0.3942862 0.8713891 0.3854747
## Stress
## Estimate Std. Error t value Pr(>|t|)
## weiblich 0.8280026 0.11304159 7.324761 4.545564e-11
## m<U+00E4>nnlich 0.7621987 0.08413254 9.059500 6.375582e-15
##
## Residual standard error: 0.884907 on 108 degrees of freedomInteraktionseffekte
model <- lm(Gesundheit ~ Stress * Geschlecht, data = data)
summary(model)
##
## Call:
## lm(formula = Gesundheit ~ Stress * Geschlecht, data = data)
##
## Residuals:
## Min 1Q Median 3Q Max
## -2.10701 -0.59281 -0.00945 0.53656 2.66007
##
## Coefficients:
## Estimate Std. Error t value Pr(>|t|)
## (Intercept) -0.1852 0.5320 -0.348 0.728
## Stress 0.8280 0.1130 7.325 4.55e-11 ***
## Geschlechtm<U+00E4>nnlich 0.5287 0.6622 0.798 0.426
## Stress:Geschlechtm<U+00E4>nnlich -0.0658 0.1409 -0.467 0.641
## ---
## Signif. codes: 0 '***' 0.001 '**' 0.01 '*' 0.05 '.' 0.1 ' ' 1
##
## Residual standard error: 0.8849 on 108 degrees of freedom
## Multiple R-squared: 0.5587, Adjusted R-squared: 0.5465
## F-statistic: 45.58 on 3 and 108 DF, p-value: < 2.2e-16library(ggplot2)
ggplot(data, aes(x = Stress, y = Gesundheit, colour = Geschlecht)) +
geom_point() +
geom_smooth(method = "lm", formula = y ~ x, se = TRUE) +
labs(y = "Beschwerdewerte", colour = "Geschlecht")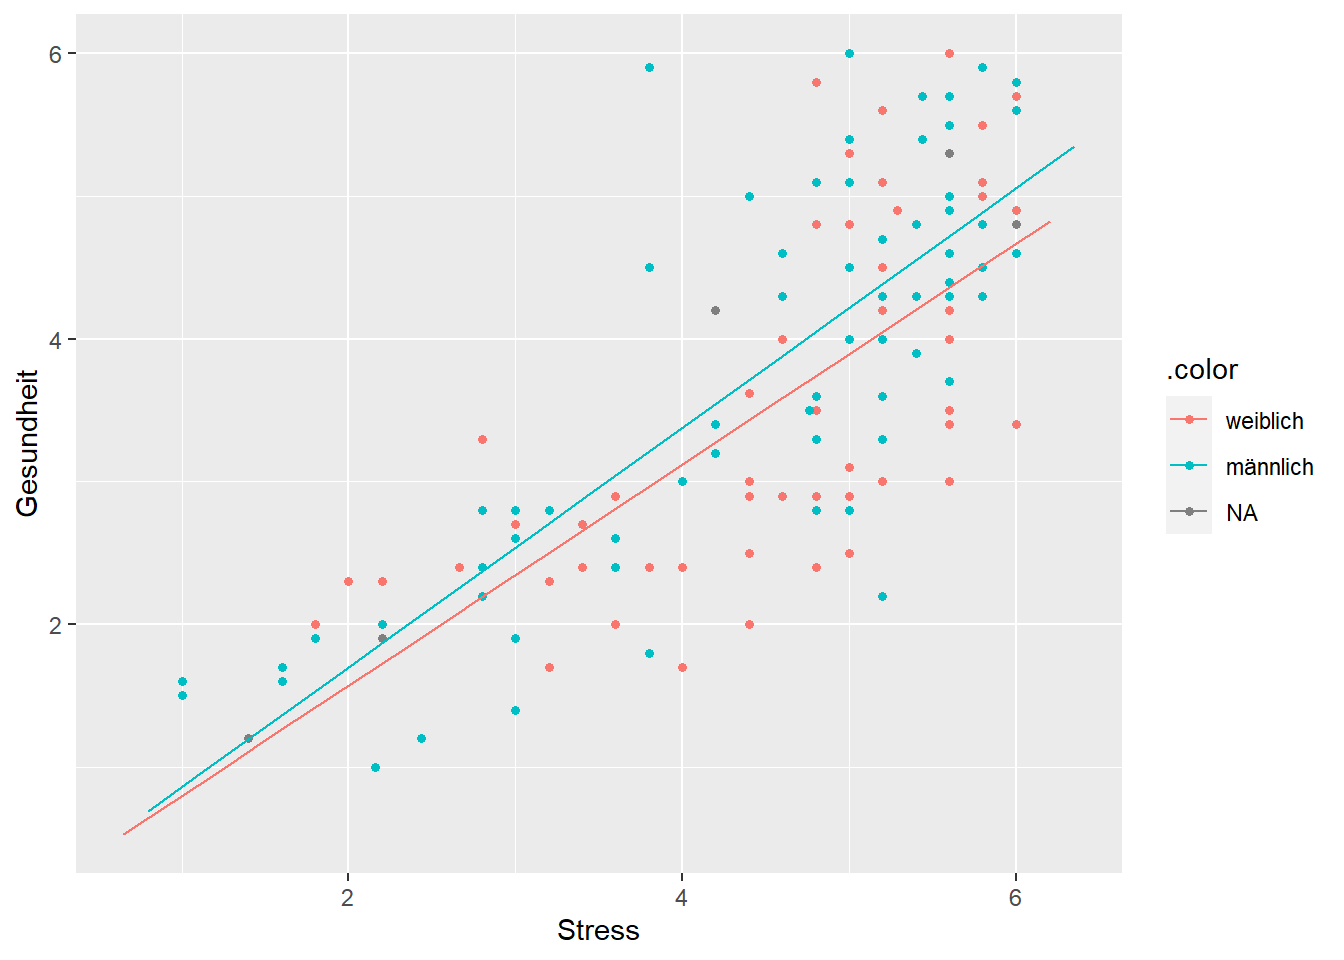
levels(data$Bildungsabschluss)## [1] "Fachhochschule" "Hochschule"
## [3] "Keinen akademischen Abschluss" "Uni"model<-lmList(Gesundheit~Stress|Bildungsabschluss, data=data)
summary(model)## Call:
## Model: Gesundheit ~ Stress | Bildungsabschluss
## Data: data
##
## Coefficients:
## (Intercept)
## Estimate Std. Error t value Pr(>|t|)
## Fachhochschule 0.05856593 0.6092339 0.09613045 0.9236020
## Hochschule 0.32972710 0.8083054 0.40792388 0.6841681
## Keinen akademischen Abschluss -0.73862341 0.7489028 -0.98627406 0.3262877
## Uni 0.64848945 0.5273684 1.22967073 0.2215950
## Stress
## Estimate Std. Error t value Pr(>|t|)
## Fachhochschule 0.8138619 0.1253802 6.491151 2.960393e-09
## Hochschule 0.7786712 0.1888107 4.124084 7.509629e-05
## Keinen akademischen Abschluss 0.9367036 0.1635896 5.725935 1.004403e-07
## Uni 0.6914147 0.1103080 6.268039 8.430936e-09
##
## Residual standard error: 0.8933251 on 104 degrees of freedomSignifikanztest zwischen zwei Gruppen bezüglich einer metrischen Variable:
Hier: Unterscheidet sich der Stress von Hochschülern signifikant von Universitätsabgängern in Bezug auf den Einfluss auf die Gesundheit
library(car)## Loading required package: carData## Registered S3 method overwritten by 'car':
## method from
## na.action.merMod lme4##
## Attaching package: 'car'## The following object is masked from 'package:psych':
##
## logit## The following objects are masked from 'package:mosaic':
##
## deltaMethod, logit## The following object is masked from 'package:dplyr':
##
## recodemodel <- lm(Gesundheit ~ Stress * Bildungsabschluss, data = data)
linearHypothesis(model, c("Stress:BildungsabschlussUni=Stress:BildungsabschlussHochschule"))##
## Linear hypothesis test:
## - Stress:BildungsabschlussHochschule + Stress:BildungsabschlussUni = 0
##
## Model 1: restricted model
## Model 2: Gesundheit ~ Stress * Bildungsabschluss
##
## Res.Df RSS Df Sum of Sq F Pr(>F)
## 1 105 83.122
## 2 104 82.995 1 0.12707 0.1592 0.69079.4 t-Tests
t Test (für unabhängige Stipo): Wenn zwei Gruppen, und Unterschied in metrischer Variablen getestet werden soll.
Forschungshypothese: Männer sind ungesünder als Frauen
- deskriptiv
favstats(Gesundheit~Geschlecht, data=data)## Geschlecht min Q1 median Q3 max mean sd n missing
## 1 weiblich 1.7 2.4 3.1 4.90 6 3.600000 1.328376 49 0
## 2 m<U+00E4>nnlich 1.4 2.8 4.0 4.75 6 3.769841 1.308488 63 0- explorativ
gf_boxplot(Gesundheit~Geschlecht, data=data)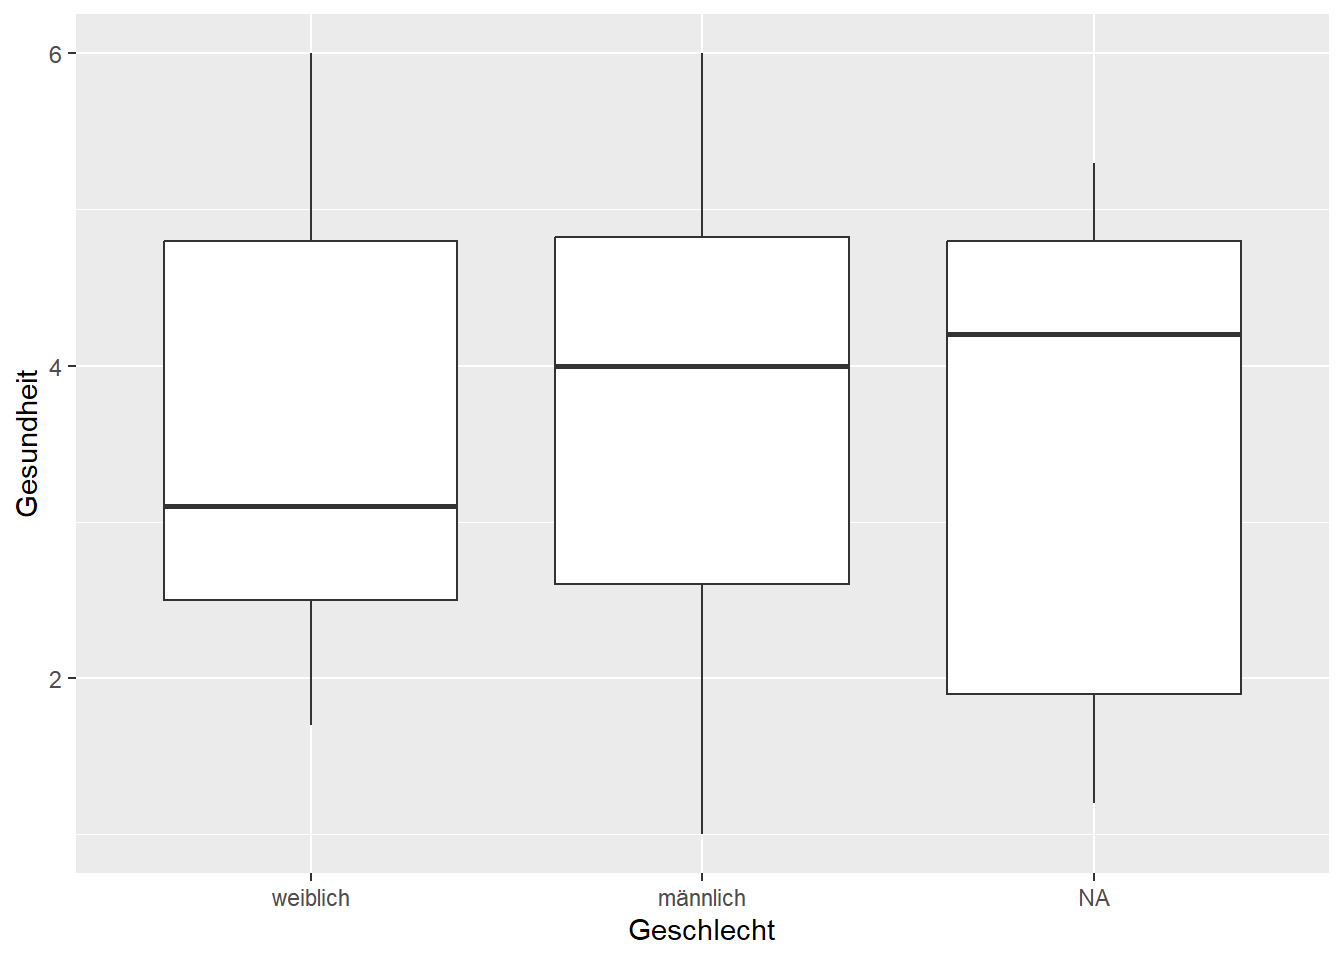
- t.test
Mit dem t-test wird die Signifikanz zwischen zwei Mittelwerten aus einer kategorialen Variablen mit zwei Ausprägungen untersucht.
Die Formelschnittstelle von t.test() verwendet die Reihenfolge der Faktorstufen. Für die gerichtete Hypothese „Männer haben höhere Beschwerdewerte als Frauen“ legen wir in einem separaten Datensatz die Reihenfolge männlich, weiblich fest. alternative = "greater" prüft dann, ob der erste Gruppenmittelwert größer ist. Die Richtung muss vor Kenntnis des Ergebnisses begründet werden.
data_ttest <- data
data_ttest$Geschlecht <- factor(data_ttest$Geschlecht,
                              levels = c("männlich", "weiblich"))
levels(data_ttest$Geschlecht)
## [1] "m<U+00E4>nnlich" "weiblich"test_geschlecht <- t.test(Gesundheit ~ Geschlecht, alternative = "greater",
data = data_ttest)
test_geschlecht##
## Welch Two Sample t-test
##
## data: Gesundheit by Geschlecht
## t = 0.67565, df = 102.56, p-value = 0.2504
## alternative hypothesis: true difference in means between group m<U+00E4>nnlich and group weiblich is greater than 0
## 95 percent confidence interval:
## -0.2474005 Inf
## sample estimates:
## mean in group m<U+00E4>nnlich mean in group weiblich
## 3.769841 3.600000Ergebnis im Beispiel: t = 0.68, p = 0.25. Bei einem vorab festgelegten 5-%-Niveau wurde die gerichtete Hypothese nicht statistisch gest<U+00FC>tzt. Das ist kein Beweis für die Gleichheit der Gruppen. Das im einseitigen Test ausgegebene Konfidenzintervall ist entsprechend einseitig.
Ein gepaarter t-Test eignet sich für verbundene Messungen, etwa Vorher-Nachher-Werte derselben Personen oder passend gebildete Paare. Untersucht wird die mittlere Differenz der zusammengehörigen Werte. Ein Beispielaufruf lautet t.test(V1, V2, paired = TRUE, alternative = "greater"). Als Ein-Stichproben-Test der Differenzen kann auch t.test(V1 - V2, mu = 0, alternative = "greater") verwendet werden.
Was machen wir, wenn es mehr als zwei kategoriale Ausprägungen in der kategorialen Variablen gibt?
9.5 Einfaktorielle Varianzanalyse (ANOVA)
Mit der Varianzanalyse (ANOVA) wird die Signifikanz zwischen mehr als zwei Mittelwerten aus einer kategorialen Variablen mit mehr als zwei Ausprägungen untersucht.
Forschungshypothese: Es gibt einen Unterschied in der Gesundheit, je nach Abschluss. oder genauer: Mindestens eine Gruppe unterscheidet sich von den anderen Gruppen.
favstats(Gesundheit~Bildungsabschluss, data=data)## Bildungsabschluss min Q1 median Q3 max mean sd n
## 1 Fachhochschule 1.5 2.725 4.10 4.750 6.0 3.846154 1.340517 26
## 2 Hochschule 1.7 2.300 3.00 4.550 5.6 3.472727 1.431147 11
## 3 Keinen akademischen Abschluss 1.7 2.400 3.05 4.625 5.6 3.453125 1.276332 32
## 4 Uni 1.4 2.850 4.00 4.900 6.0 3.841860 1.307530 43
## missing
## 1 0
## 2 0
## 3 0
## 4 0gf_boxplot(Gesundheit~Bildungsabschluss, data=data)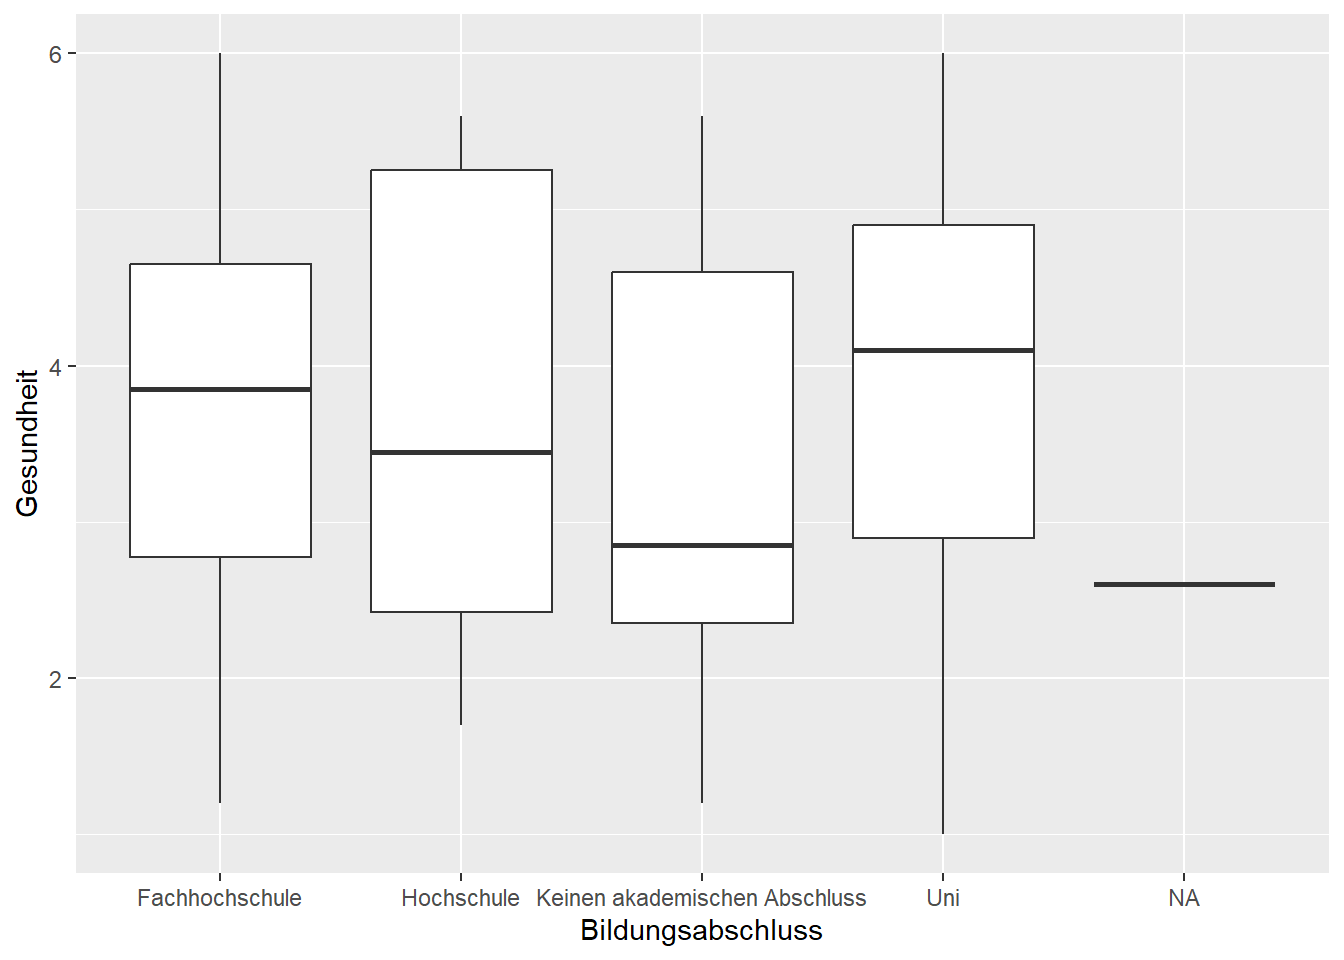
modell_anova <- aov(Gesundheit ~ Bildungsabschluss, data = data)
summary(modell_anova)
## Df Sum Sq Mean Sq F value Pr(>F)
## Bildungsabschluss 3 3.94 1.312 0.755 0.522
## Residuals 108 187.71 1.738Der globale F-Test prüft die Nullhypothese gleicher Gruppenmittelwerte. Ein nicht signifikanter Test weist keinen ausreichenden statistischen Widerspruch zu dieser Nullhypothese nach; er beweist nicht die Gleichheit aller Gruppen. Welche Gruppen sich gegebenenfalls unterscheiden, wird durch geeignete Kontraste oder Vergleichsverfahren untersucht.
9.6 Multivariate Varianzanalyse (MANOVA)
modell_manova <- manova(cbind(Stress, Erschoepfung) ~ Bildungsabschluss, data = data)
summary(modell_manova, test = "Pillai") # gemeinsamer multivariater Test
## Df Pillai approx F num Df den Df Pr(>F)
## Bildungsabschluss 3 0.031918 0.58385 6 216 0.743
## Residuals 108summary.aov(modell_manova) # ergänzende univariate ANOVA-Tabellen## Response Stress :
## Df Sum Sq Mean Sq F value Pr(>F)
## Bildungsabschluss 3 3.513 1.1711 0.7504 0.5244
## Residuals 108 168.555 1.5607
##
## Response Erschoepfung :
## Df Sum Sq Mean Sq F value Pr(>F)
## Bildungsabschluss 3 0.786 0.2621 0.1691 0.917
## Residuals 108 167.372 1.5497..und das ganze noch graphisch via Boxplot
library(ggpubr) #ggf. vorher installieren## Registered S3 methods overwritten by 'broom':
## method from
## tidy.glht jtools
## tidy.summary.glht jtoolsdata %>%
na.omit()%>%
ggboxplot(x = "Bildungsabschluss", y = c("Stress", "Erschoepfung"),
merge = TRUE, palette = "jco")## Warning: The `size` argument of `element_line()` is deprecated as of ggplot2 3.4.0.
## i Please use the `linewidth` argument instead.
## i The deprecated feature was likely used in the ggpubr package.
## Please report the issue at <https://github.com/kassambara/ggpubr/issues>.
## This warning is displayed once per session.
## Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
## generated.## Warning: The `size` argument of `element_rect()` is deprecated as of ggplot2 3.4.0.
## i Please use the `linewidth` argument instead.
## i The deprecated feature was likely used in the ggpubr package.
## Please report the issue at <https://github.com/kassambara/ggpubr/issues>.
## This warning is displayed once per session.
## Call `lifecycle::last_lifecycle_warnings()` to see where this warning was
## generated.## Ignoring unknown labels:
## * fill : ""
## * linetype : ""
## * shape : ""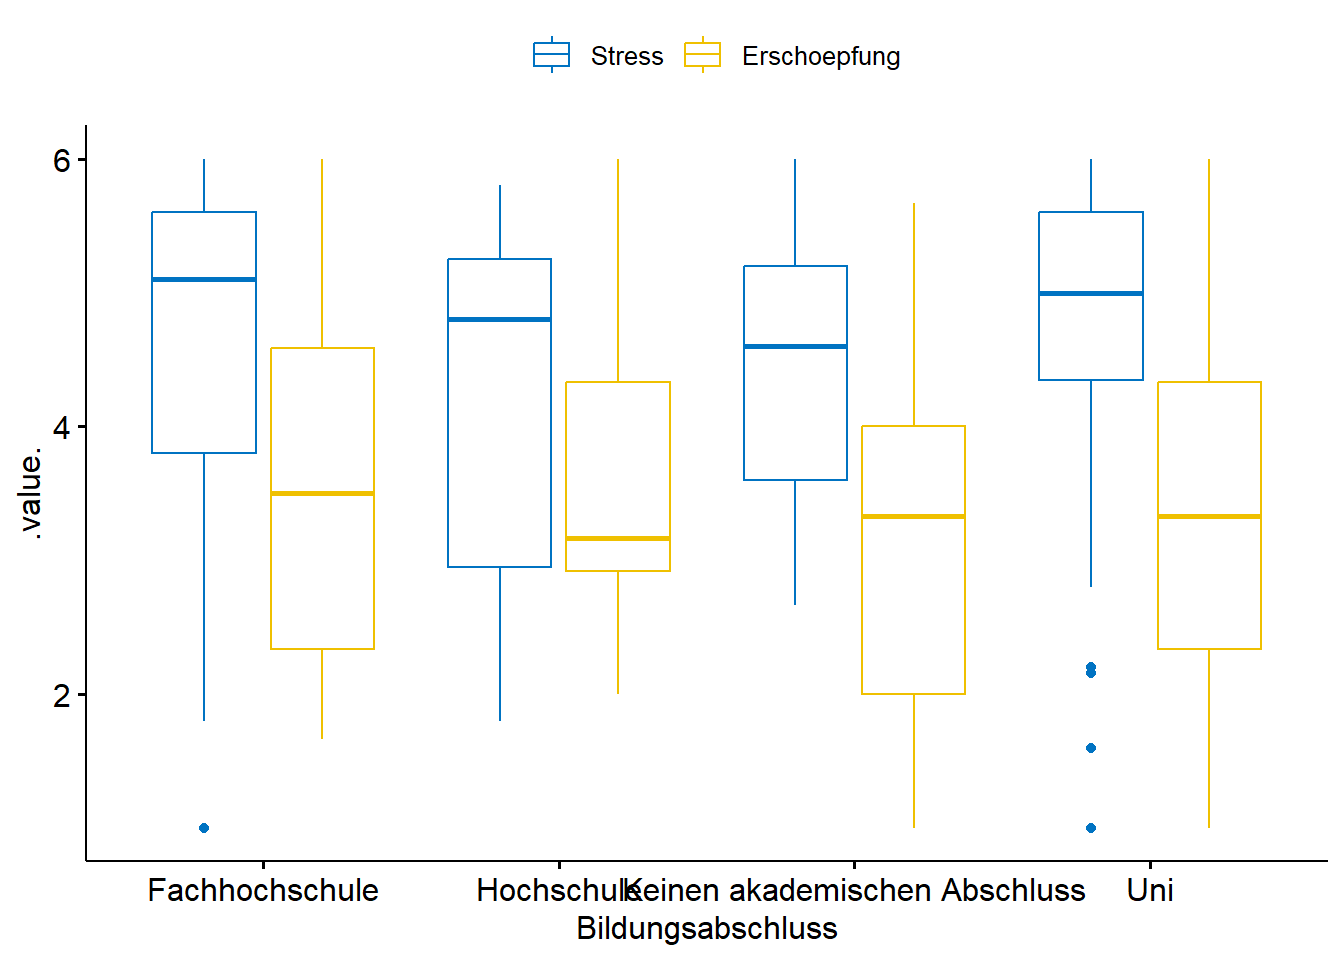
data%>%
  na.omit()%>%
ggqqplot("Stress", facet.by = "Bildungsabschluss",
ylab = "", ggtheme = theme_bw())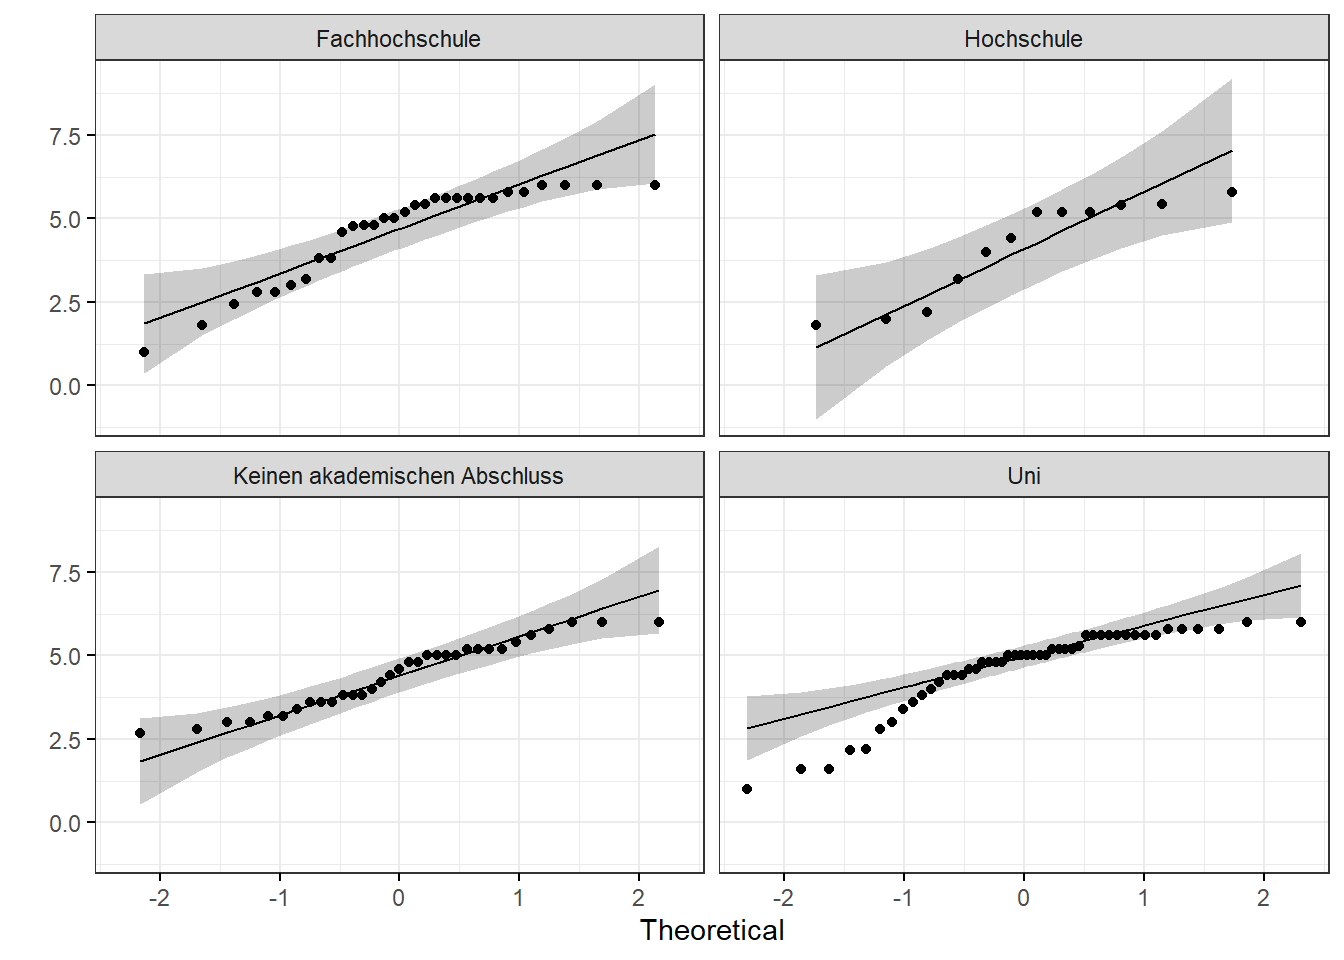
9.7 Post-hoc Test bei der Varianzanalyse
Mit pairwise.t.test() können paarweise Gruppenvergleiche durchgeführt werden. Die Zahl der Vergleiche und die Korrektur für multiples Testen werden berücksichtigt. Ein signifikanter globaler Test ist nicht für jedes geplante Kontrastverfahren eine zwingende Voraussetzung. Fragestellung und Auswertungsplan bestimmen das Vorgehen. Hier zeigen wir zur Demonstration alle Paarvergleiche mit Holm-Korrektur.
pairwise.t.test(data$Gesundheit, data$Bildungsabschluss, p.adjust.method = "holm")##
## Pairwise comparisons using t tests with pooled SD
##
## data: data$Gesundheit and data$Bildungsabschluss
##
## Fachhochschule Hochschule
## Hochschule 1 -
## Keinen akademischen Abschluss 1 1
## Uni 1 1
## Keinen akademischen Abschluss
## Hochschule -
## Keinen akademischen Abschluss -
## Uni 1
##
## P value adjustment method: holmIn der Matrix stehen die Holm-korrigierten p-Werte der Vergleichspaare. Nicht signifikante Vergleiche belegen keine Gleichheit der Gruppen. Ihre Ergebnisse sind zusammen mit Mittelwertunterschieden und deren Unsicherheit zu beurteilen.
9.8 Chi-Quadrat-Unabhängigkeitstest
Chi-Square: Abhängigkeit zwischen zwei nominalen Variablen (Faktor-Variablen).
Forschungsfrage: Gibt es eine Abhängigkeit zwischen Geschlecht und Berufliche Belastung?
Hilfreich ist immer eine Tabelle:
data_chi <- data[complete.cases(data[c("Geschlecht", "Berufliche.Belastung")]), ]
Tabelle <- with(data_chi, table(Geschlecht, Berufliche.Belastung))
Tabelle
## Berufliche.Belastung
## Geschlecht ja nein
## weiblich 35 14
## m<U+00E4>nnlich 39 24prop.table(Tabelle) * 100 # Prozentwerte nur zur Beschreibung## Berufliche.Belastung
## Geschlecht ja nein
## weiblich 31.25000 12.50000
## m<U+00E4>nnlich 34.82143 21.42857Der Test verwendet beobachtete Fallzahlen, keine Prozentwerte:
test_chi <- chisq.test(Tabelle)
test_chi
##
## Pearson's Chi-squared test with Yates' continuity correction
##
## data: Tabelle
## X-squared = 0.73084, df = 1, p-value = 0.3926test_chi$expected # erwartete Fallzahlen unter der Nullhypothese## Berufliche.Belastung
## Geschlecht ja nein
## weiblich 32.375 16.625
## m<U+00E4>nnlich 41.625 21.375Ergebnis im Beispiel: χ² = 0.73, p = 0.393. Bei einem vorab festgelegten 5-%-Niveau wurde kein statistischer Zusammenhang nachgewiesen. Ein nicht signifikanter Befund beweist keine Unabhängigkeit. Die Chi-Quadrat-Approximation setzt hinreichend große erwartete Fallzahlen voraus. Bei einer dünn besetzten 2×2-Tabelle ist beispielsweise fisher.test(Tabelle) eine mögliche Alternative. Bei 2×2-Tabellen verwendet chisq.test() standardmäßig eine Kontinuitätskorrektur.
9.9 Auf was ist zu achten bei der Fragebogenerstellung (Art der Fragen, Skalierung, etc.)?
Hierzu ist mein Leitfaden hilfreich.
10 Versuchsplanung
10.1 Problemstellung
Die Fragestellung einer Studie ist z. B. der Einfluss der Anzahl Emoticons bei Newslettertexten auf die Wahrnehmung der Empfänger des Newsletters. Hierzu gibt es eine Theorie, dass die Wahrnehmung variiert, abhängig von der Anzahl Emoticons im Text. Da auch der Text einen Einfluss auf die Variation hat, bietet sich für die Untersuchung ein Experimentaldesign an, bei dem der Text kontrolliert wird, d. h. weitestgehend keinen Einfluss hat und die Anzahl Emoticons manipuliert wird.
10.2 Ziel der Versuchsplanung
- Die Elemente eines Versuchsplans sind die Versuchseinheiten und die Behandlungen.
- Die Behandlungen werden den Einheiten zugeordnet
Ziel:
Vergleich der Behandlungen
10.3 Versuchsplanung im Marketing
Im Marketing sind
- die Personen in den verschiedenen Experimentalgruppen die Einheiten.
- die getesteten Maßnahmen die Behandlungen.
10.4 Grundprinzipien der Versuchsplanung
Jede Versuchsplanung basiert auf drei Grundprinzipien:
- Lokale Kontrolle
- Wiederholung
- Randomisierung
10.4.1 Lokale Kontrolle
Bezieht sich auf jede Methode, die natürliche Schwankungen erklärt und reduziert.
Eine Möglichkeit ist die Einteilung ähnlicher Versuchseinheiten in Blöcke.
Im Marketing kann ein Block z. b. eine Werbeanzeige sein, in der verschiedene Behandlungen getestet werden.
10.4.2 Wiederholung
Dieselbe Behandlung wird auf verschiedene Versuchseinheiten angewendet.
Ohne Wiederholung ist es unmöglich, natürliche Schwankungen und Messfehler abzuschätzen
10.4.3 Randomisierung
Randomisierung ist der wesentliche Schritt in jedem statistischen Verfahren. Die Behandlungen müssen den Versuchseinheiten zufällig zugeordnet werden.
10.5 Versuchsplan
Wenn wir die Anzahl Behandlungen unabhängig vom Text untersuchen wollen, müssen wir die Behandlungen mit verschiedenen Texten anbieten. Da wir vier Behandlungen haben, bieten sich auch vier verschiedenen Texte an.
Alle vier Behandlungen werden nun in jedem Text (Block) wiederholt.
Wir nehmen nun die 4 Behandlungen und weisen die Behandlungen nachfolgendem Schema zu.
G = Personengruppen mit Anzahl Emoticons im Text C = Kontrollgruppe E = Experimentalgruppen mit 1,2und 3 Emoticons
| Texte | G1 | G2 | G3 | G4 |
|---|---|---|---|---|
| A | C | E1 | E2 | E3 |
| B | E1 | E2 | E3 | C |
| C | E2 | E3 | C | E1 |
| D | E3 | C | E1 | E2 |
10.6 Lateinisches Quadrat
Eine 4 x 4 Tabelle mit vier verschiedenen Elementen, von denen jedes in einer Zeile und Spalte genau einmal auftritt, heißt Lateinisches Quadrat.
In diesem Experiment erhalten die vier Personengruppe und die vier Texte jede Behandlung genau einmal.
Es gibt somit 4 Experimentalgruppen, die je Text oder auch aggregiert auf Unterschiedlichkeit bezüglich der Wirkung untersucht werden können.
10.7 Die Funktion gather für die Datentransformation bei Experimenten
Wurden für eine experimentelle Versuchsplanung z. B. verschiedene Produkte bei einer Auskunftsperson abgefragt mit denselben Konstrukten, müssen die Daten transponiert werden (oder aus einen breiten einen langen Datensatz machen), so dass eine Variable nur einmal im Datensatz vorkommen, anstatt mehrmals pro Produkt. Die verschiedenen Produkte sind in eine Variable zu packen, die sozusagen eine Produktgruppe (oder einfach nur alle Produkte) darstellt. Die Werte dazu für die Variable muss natürlich hier mitgenommen werden in einer weiteren Spalte.
Wir können dies beispielsweise hier tun mit den drei Variablen Stress, Erschoepfung und Gesundheit und verwenden dazu die Funktion gather:
data%>%
  tidyr::gather(key = key, value = value, c("Stress", "Erschoepfung", "Gesundheit") )%>%
  head() # zeigt die ersten 6 Zeilen des neuen Datensatzes
## V3_1 V3_2 V3_3 V3_4 V3_5 V3_6 V3_7 V3_8 V3_9 Berufliche.Belastung V9_1 V9_2
## 1 2 2 3 1 1 3 2 2 4 ja 2 1
## 2 5 5 5 6 4 5 5 4 5 nein 5 6
## 3 2 2 3 1 1 2 2 3 1 ja 2 1
## 4 5 2 5 6 6 6 2 6 6 ja 6 6
## 5 3 4 5 6 6 5 3 6 6 nein 5 5
## 6 5 4 4 4 4 3 2 5 5 nein 5 1
## V9_3 V9_4 V10_1 V10_2 V10_3 V10_4 V10_5 V10_6 Geschlecht
## 1 1 1 6 2 2 1 2 2 m<U+00E4>nnlich
## 2 4 5 5 5 6 5 5 5 m<U+00E4>nnlich
## 3 1 2 2 2 2 1 2 2 m<U+00E4>nnlich
## 4 4 2 6 6 5 5 3 3 weiblich
## 5 6 2 6 6 6 4 5 6 m<U+00E4>nnlich
## 6 1 2 4 5 4 4 4 4 m<U+00E4>nnlich
## Bildungsabschluss key value
## 1 Uni Stress 2.2
## 2 Keinen akademischen Abschluss Stress 4.8
## 3 Uni Stress 1.6
## 4 Keinen akademischen Abschluss Stress 6.0
## 5 Uni Stress 5.8
## 6 Uni Stress 4.2data%>%
tidyr::gather(key = key, value = value, c("Stress", "Erschoepfung", "Gesundheit") )%>%
tail() # zeigt die letzten 6 Zeilen des neuen Datensatzes ## V3_1 V3_2 V3_3 V3_4 V3_5 V3_6 V3_7 V3_8 V3_9 Berufliche.Belastung V9_1 V9_2
## 331 3 5 6 5 5 3 2 5 5 ja 6 5
## 332 4 4 4 5 4 5 5 5 5 nein 6 4
## 333 3 3 5 2 3 4 2 5 5 ja 6 5
## 334 3 3 4 4 4 4 4 5 4 ja 6 4
## 335 2 2 1 6 5 4 4 6 5 ja 2 2
## 336 2 2 2 5 5 4 6 6 6 ja 6 4
## V9_3 V9_4 V10_1 V10_2 V10_3 V10_4 V10_5 V10_6 Geschlecht
## 331 2 1 5 5 5 5 5 1 weiblich
## 332 5 4 5 5 5 5 4 5 weiblich
## 333 5 3 5 5 3 4 5 4 m<U+00E4>nnlich
## 334 5 5 2 2 2 2 2 2 m<U+00E4>nnlich
## 335 1 2 2 5 1 2 3 2 m<U+00E4>nnlich
## 336 2 5 4 3 4 4 5 5 weiblich
## Bildungsabschluss key value
## 331 Uni Gesundheit 4.0
## 332 Fachhochschule Gesundheit 4.8
## 333 Keinen akademischen Abschluss Gesundheit 4.5
## 334 Keinen akademischen Abschluss Gesundheit 3.2
## 335 Keinen akademischen Abschluss Gesundheit 2.2
## 336 Uni Gesundheit 4.2Der Gesamte Datensatz hat sich nun bezüglich der Zeilenanzahl verdreifacht und anstatt der Variablen Stress, Erschoepfung und Gesundheit gibt in den letzten zwei Spalten eine Variable Key und Value. Key enthält die drei Variablen und Value den Wert dazu. Jetzt muss der neue lange Datensatz nur noch gespeichert werden mit data<-data%>%…
11 Mögliche Darstellung von Tabellen
Mit APA-Tables können viele Ergebnis in perfekter Form als Word Tabelle im APA Style gespeichert werden.
An den Code ist nur anzupassen:
- Datendateiname
- Variablenauswahl mit data[]
12 Wie kann ich vermeiden zu häufig gleiche Wörter zu verwenden?
library(tidyverse) library(tidytext)
lines <- read-lines (“text.Rmd”)
paper<- tibble (line= line) %>% unnest-tokens(word,line) %>% anti-join(stop_words) %>%
paper %>% count(word,sort=TRUS) %>% filter (n>20)